
Java-паттерны и анти-паттерны для агентской разработки, часть 3: логирование

Статья — продолжение первой части «Концептуальные основы» и второй части «Паттерны раннего обнаружения ошибок». Она адресована техническим лидам и архитекторам, которые внедряют LLM-агентов (в первую очередь Claude Code) в качестве co-pilot’а или автономного исполнителя задач в Java-проектах.
Первая часть закладывала концептуальный фундамент и описывала базовые паттерны. Во второй части мы описали более сложные паттерны и ловушки, сгруппированные по слоям стека. Эта часть целиком посвящена логированию — обычно недооценённому аспекту.
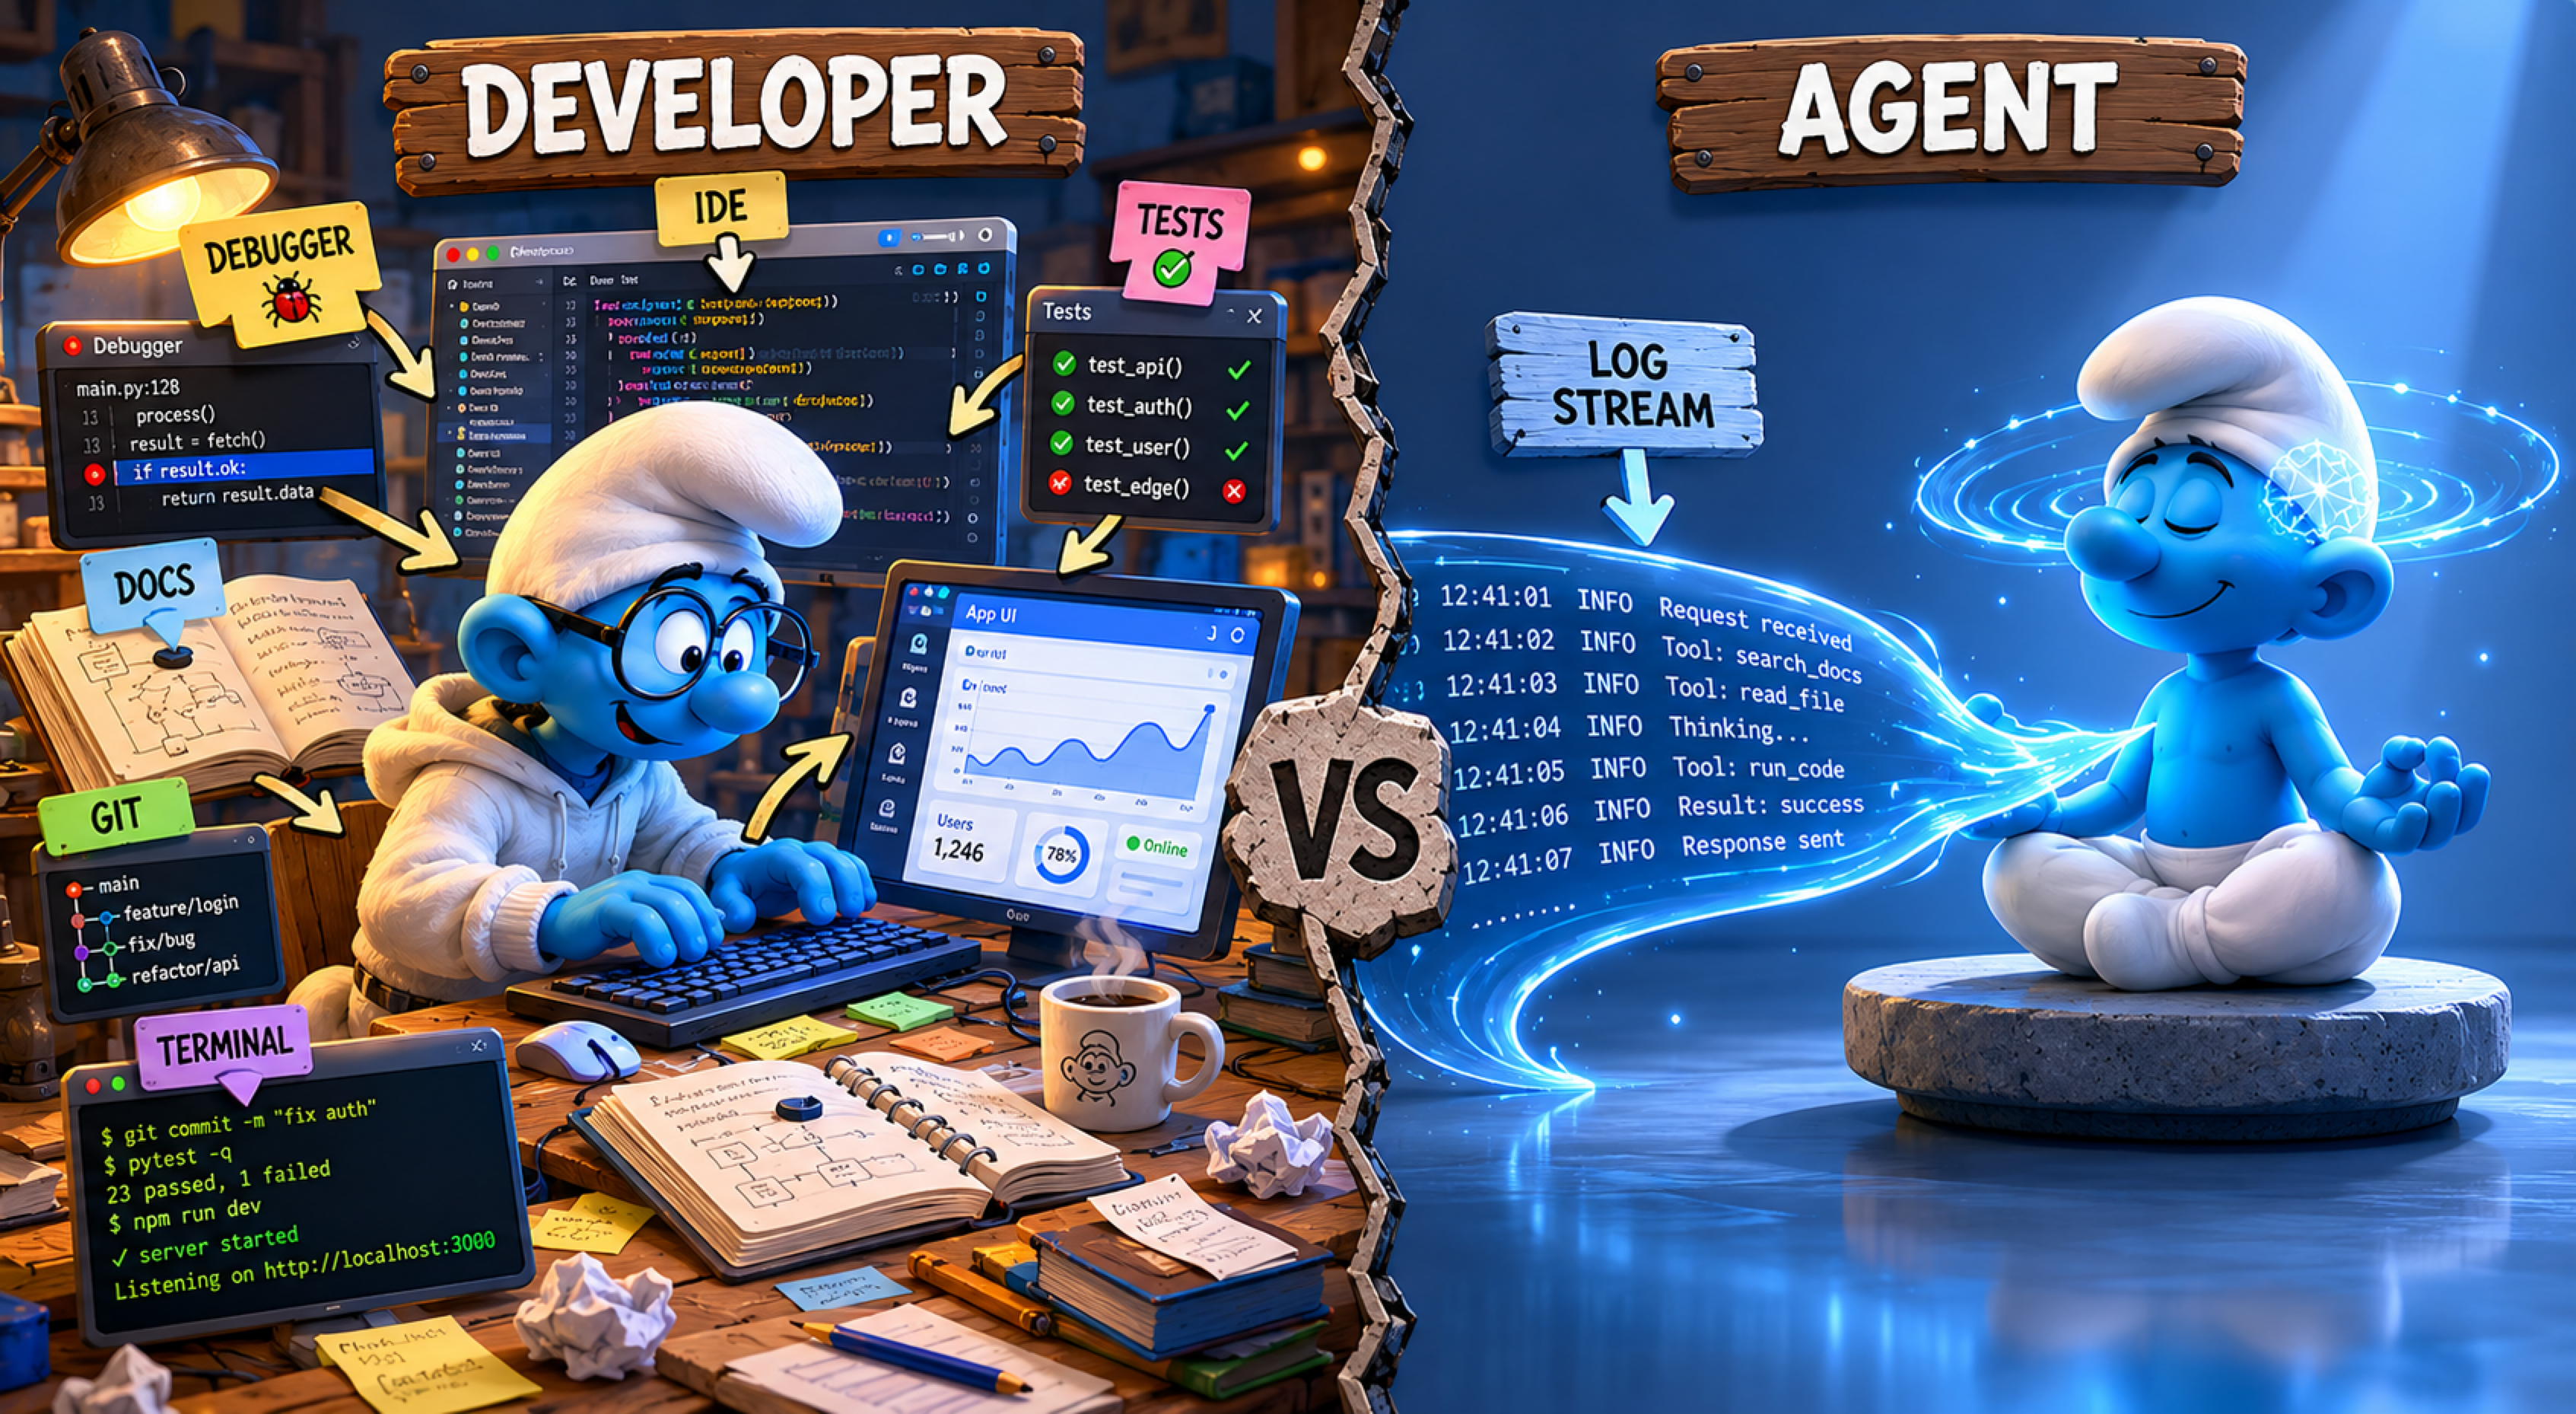
Программа всегда что-то делает, но для агента это «что-то» существует только в той мере, в которой оно зафиксировано. Разработчик использует отладчик, IDE и терминал; у агента этих каналов нет — только лог и история коммитов.
Это кардинально меняет статус логирования и git-истории. Лог — не вспомогательный артефакт, а первичная реальность системы: по нему агент восстанавливает причинно-следственные цепочки, локализует сбои и верифицирует инварианты. Git-история — не архив изменений, а база знаний о намерениях: она отвечает на вопрос «почему», на который код ответа не даёт. Паттерны этой части делают оба источника достаточно структурированными и полными, чтобы агент мог действовать точно, а не угадывать.
Логирование
Паттерны этой группы делают поведение системы читаемым — для агента, оператора и клиента API — без необходимости заглядывать в БД или исходный код.
Человек, разрабатывающий программу, получает обратную связь многими способами: он запускает отладчик и останавливает выполнение в точке интереса, просматривает переменные в IDE, читает вывод в терминале, наблюдает за поведением UI. Агент лишён всего этого. Единственный канал, по которому программа сообщает агенту, что произошло во время её выполнения, — это лог. Если событие не отражено в логе, для агента его не существует; если оно отражено неточно или неполно, агент строит картину происходящего по неверным данным и делает из них неверные выводы.
Из этого следует общее требование, которое объединяет все паттерны раздела: лог должен быть достаточно структурированным и полным, чтобы агент мог восстановить по нему причинно-следственную цепочку любого наблюдаемого поведения системы без повторного запуска программы, без доступа к исходному коду в рантайме и без итеративного добавления новых инструкций по логированию. Каждый паттерн решает конкретную часть этой задачи: идентификацию (какая именно сущность и операция породили запись), контекст (при каком запросе и в каком состоянии), полноту (что именно ушло на внешнюю границу и что вернулось). Взятые вместе, они превращают лог из последовательности сообщений в точную модель поведения работающей системы, пригодную для анализа, верификации и диагностики.
Structured logging с entity ID
Анти-паттерн: логирование ведётся в свободном тексте без привязки к идентификаторам сущностей.
Реализация:
Каждая лог-запись содержит стандартные структурированные поля:
operation,entityId,requestId,customerId,state.Используем MDC для сквозного
requestIdилиtraceId.Для JSON-форматирования в стеке Logback: logstash-logback-encoder (требует Logback ≥ 1.3.0; актуально для стеков, не перешедших на Spring Boot 3.4); начиная со Spring Boot 3.4 — встроенная поддержка структурированного логирования без дополнительных зависимостей: форматы ECS, Logstash и GELF доступны через
logging.structured.format.console(иlogging.structured.format.fileдля файлового аппендера); также поддерживается SLF4J 2 fluent API с key-value pairs.
Практика применения:
Не логируем чувствительные данные в DEBUG-уровне по умолчанию.
Один structured logging framework на проект.
Пример реализации
// Плохо
log.info("Invoice created successfully");

// Хорошо — import static net.logstash.logback.argument.StructuredArguments.kv;
log.info("invoice.created",
    kv("invoiceId",  invoice.id().value()),
    kv("customerId", command.customerId().value()),
    kv("requestId",  command.requestId().value()),
    kv("amount",     invoice.amount().amount())
);
Словарь событий логирования
Анти-паттерн: каждый разработчик именует события произвольно — "Invoice created", "Created invoice", "invoice_create", "InvoiceService: done". Агент не может надёжно найти все события одного типа по имени и вынужден угадывать вариант написания.
Реализация:
Имена событий — это контракт, зафиксированный в одном месте: константах или перечислении рядом с доменным кодом. Форма:
<домен>.<действие>в нижнем регистре с разделителем-точкой, глагол в прошедшем времени.Словарь событий ведётся явно — например, как файл
LogEvents.javaилиlog-events.adocв корне модуля — и входит в его публичный API наравне с командами и доменными событиями.Каждое имя события соответствует конкретному переходу состояния или значимому факту в жизненном цикле сущности; события не дублируют друг друга и не перекрываются по смыслу.
Пример словаря (константы)
// LogEvents.java — единственный источник правды об именах событий
public final class LogEvents {
    // Invoice lifecycle
    public static final String INVOICE_CREATED       = "invoice.created";
    public static final String INVOICE_SENT          = "invoice.sent";
    public static final String INVOICE_PAID          = "invoice.paid";
    public static final String INVOICE_OVERDUE       = "invoice.overdue";
    public static final String INVOICE_CANCELLED     = "invoice.cancelled";
    // Validation failures
    public static final String INVOICE_REJECTED      = "invoice.rejected";
    // Not-found / conflict
    public static final String INVOICE_NOT_FOUND     = "invoice.not_found";
    public static final String INVOICE_DUPLICATE     = "invoice.duplicate";

    private LogEvents() {}
}
Пример использования в use case
log.info(INVOICE_CREATED,
    kv("invoiceId",  invoice.id().value()),
    kv("customerId", command.customerId().value()),
    kv("requestId",  command.requestId().value()),
    kv("amount",     invoice.amount().amount())
);
Практика применения:
Имя события пишется первым аргументом
log.info(EVENT_NAME, kv(…))— оно попадает в полеmessageJSON-записи и индексируется в Kibana / Loki.Агрегирующий запрос по имени события (
message: "invoice.created") даёт полную историю всех созданных счётов в любом временном окне без разбора текста сообщений.При добавлении нового события в код — нужная константа добавляется в словарь в том же коммите. Это делает diff словаря точным журналом того, какое поведение системы стало наблюдаемым и когда.
Почему это важно для агента: агент обращается к логу через поиск по именам событий. Стабильный, исчерпывающий словарь — это индекс всех наблюдаемых фактов системы. Без него агент не может гарантированно найти все вхождения события, отличить «счёт создан» от «счёт создан повторно» и выстроить полную хронологию жизненного цикла сущности.
Structured logging в @ExceptionHandler / @ControllerAdvice
Анти-паттерн: обработчик исключений логирует только сообщение ошибки, не включая requestId и контекст — теряется связь между ошибкой в логе и конкретным запросом.
Реализация:
В
@ControllerAdviceлогируем исключение вместе с теми же структурированными полями, что и в use case:requestId,operation, идентификатор сущности.requestIdберём из MDC или из HTTP-заголовка запроса.
Практика применения:
Доменные исключения логируем на уровне
WARN, технические —ERROR.Stack trace — только в лог, не в тело HTTP-ответа.
Почему это важно для агента: без requestId агент не может связать ошибку в логе с конкретным вызовом — диагностика становится угадыванием.
Пример реализации
// Плохо
@ExceptionHandler(InvoiceNotFoundException.class)
public ResponseEntity<String> handle(InvoiceNotFoundException ex) {
    log.error("Invoice not found"); // нет requestId, нет invoiceId
    return ResponseEntity.notFound().build();
}

// Хорошо — import static net.logstash.logback.argument.StructuredArguments.kv;
@ExceptionHandler(InvoiceNotFoundException.class)
public ResponseEntity<ProblemDetail> handle(
        InvoiceNotFoundException ex,
        HttpServletRequest request) {
    log.warn(INVOICE_NOT_FOUND,
        kv("invoiceId", ex.invoiceId().value()),
        kv("requestId", MDC.get("requestId")),
        kv("path",      request.getRequestURI())
    );
    ProblemDetail problem = ProblemDetail.forStatusAndDetail(
        HttpStatus.NOT_FOUND,
        "Invoice '" + ex.invoiceId().value() + "' does not exist"
    );
    problem.setType(URI.create("https://api.example.com/errors/invoice-not-found"));
    return ResponseEntity.status(HttpStatus.NOT_FOUND).body(problem);
}
Логирование переходов состояний
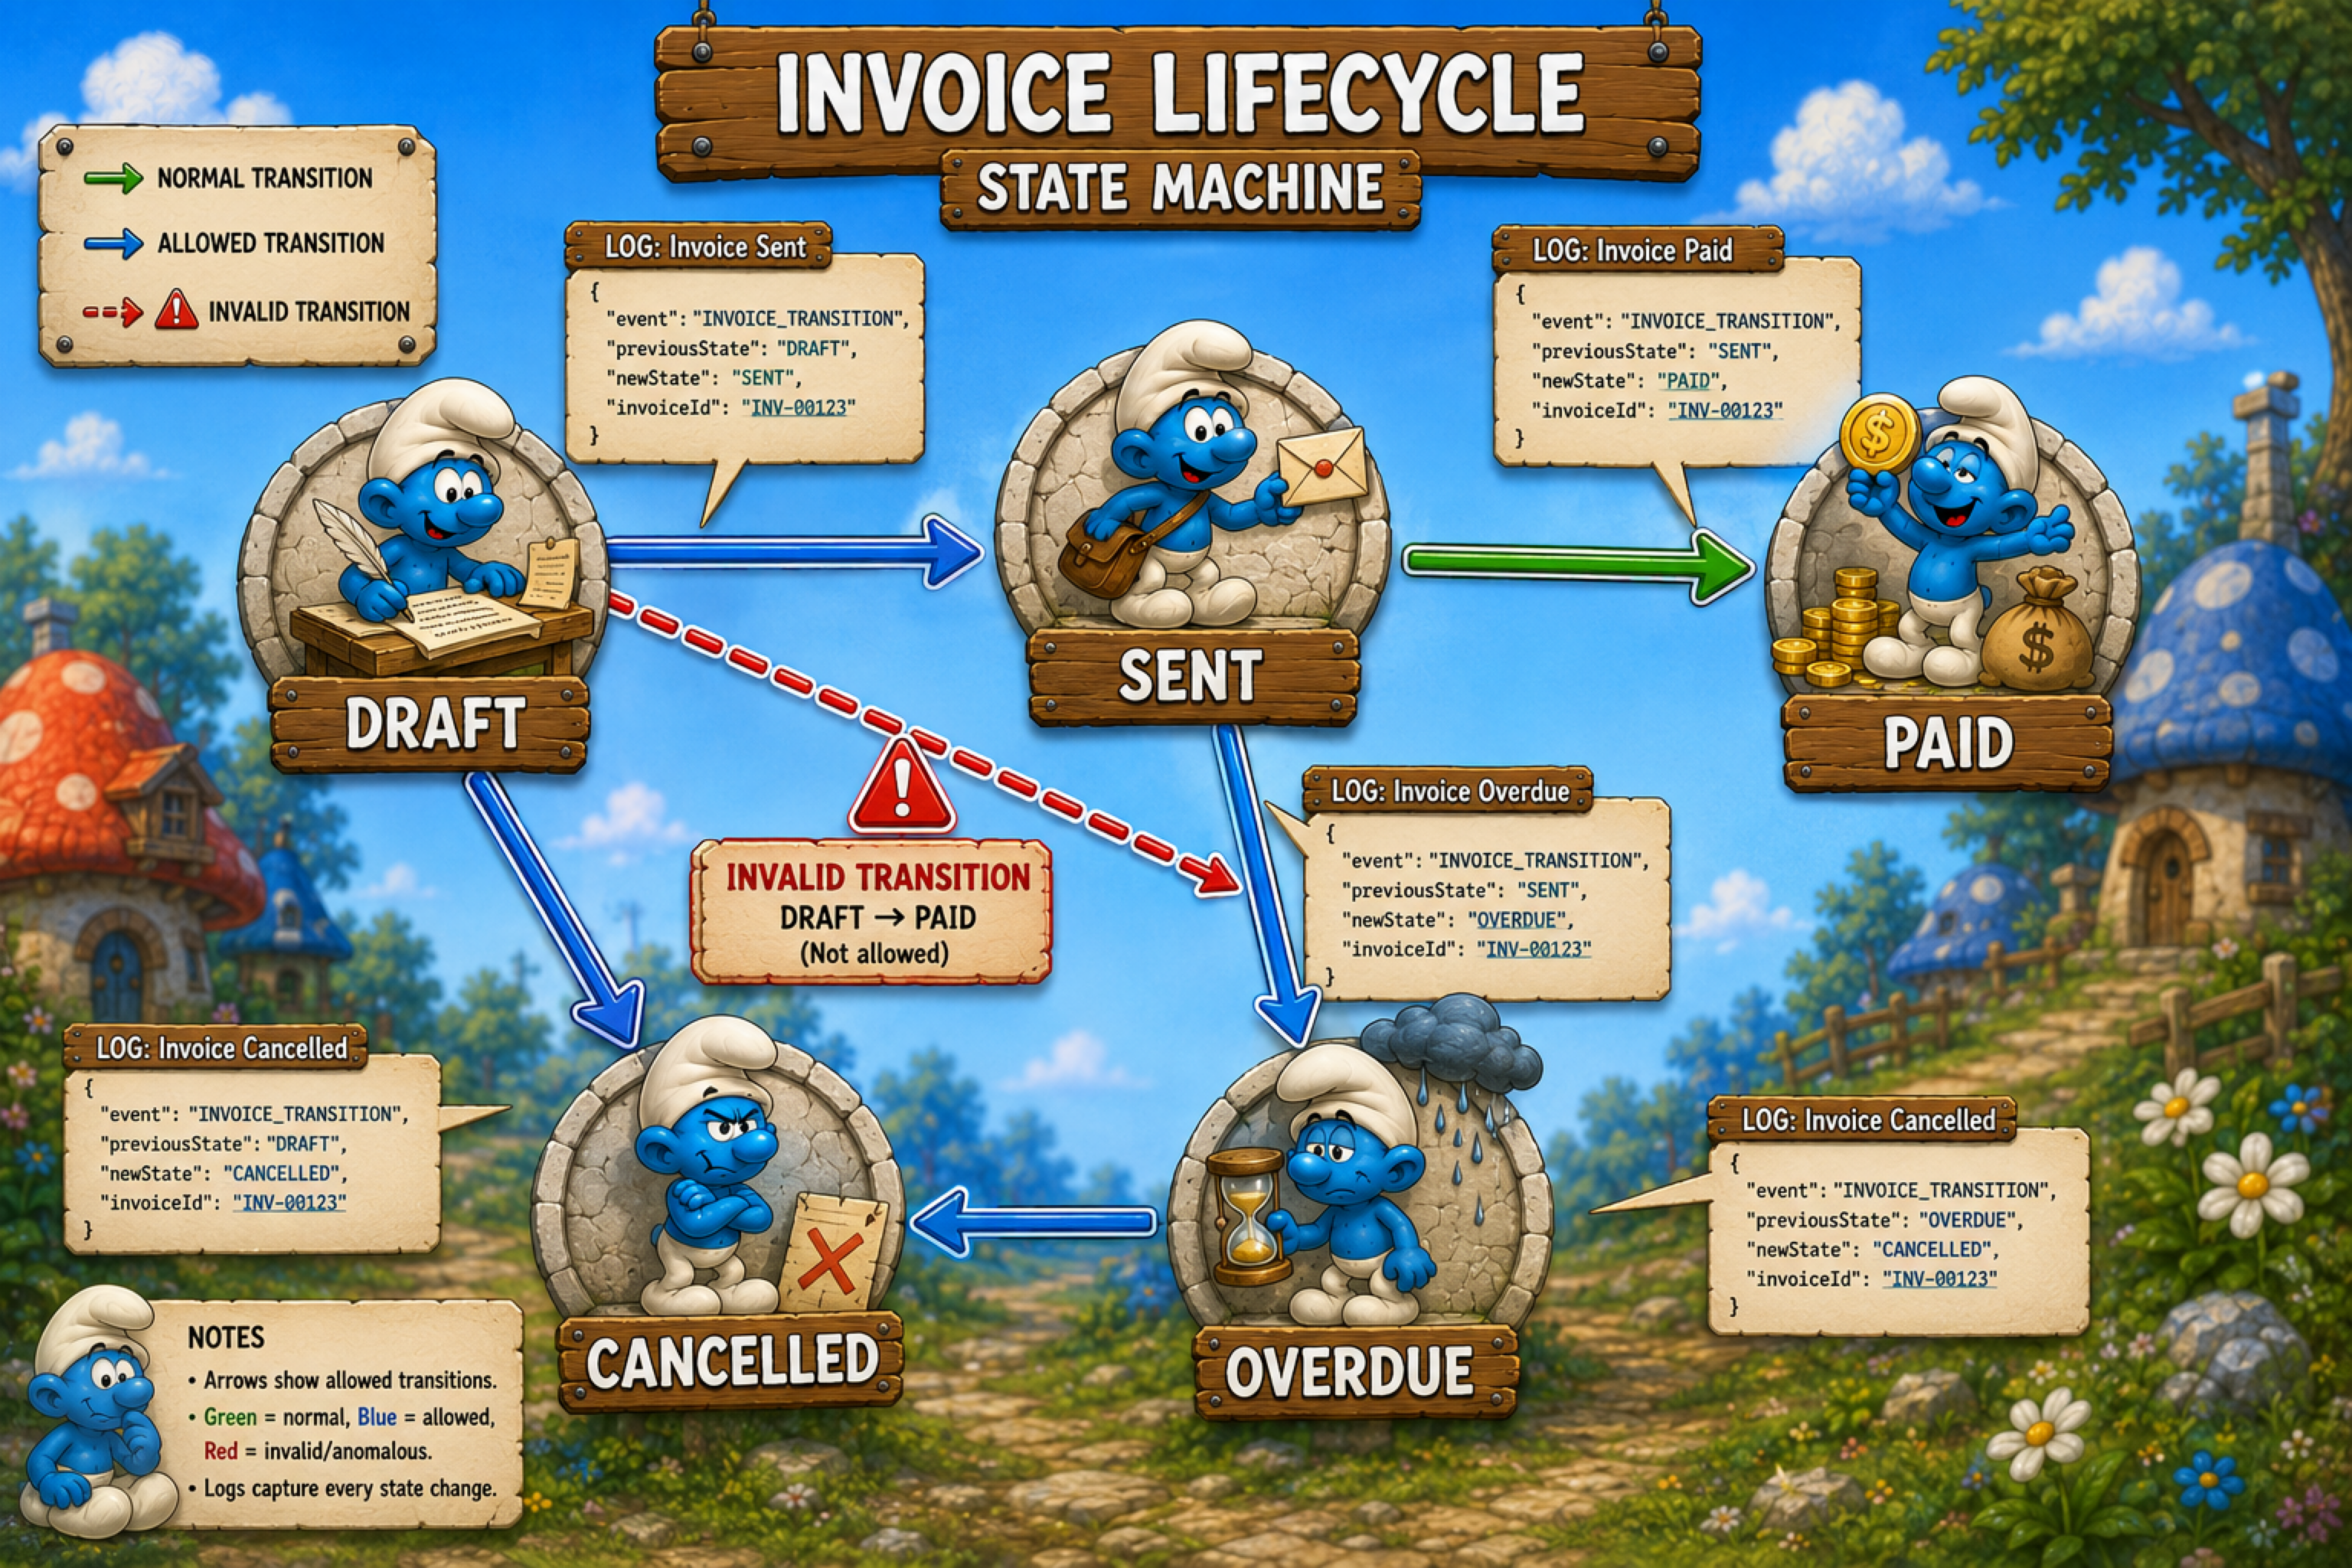
Анти-паттерн: в логе фиксируется только факт достижения нового состояния (например, "invoice.paid") без указания предыдущего. При диагностике непонятно, был ли переход корректным: из SENT в PAID — норма, из DRAFT в PAID — дефект; в логе оба выглядят одинаково.
Реализация:
При каждом значимом переходе состояния логируем поля
previousStateиnewStateрядом с идентификатором сущности иrequestId.Запись об изменении состояния — отдельное событие: она не совмещается с событием команды и не заменяет его.
Имя события при этом остаётся без изменений (
invoice.paid) —previousStateиnewStateслужат дополнительными измерениями, а не частью имени.
Пример реализации
// В доменном сервисе или агрегате — после применения команды
InvoiceState before = invoice.state();           // состояние до команды
invoice.markAsPaid(payment);                     // применяем команду
InvoiceState after  = invoice.state();           // состояние после

log.info(INVOICE_PAID,
    kv("invoiceId",     invoice.id().value()),
    kv("customerId",    invoice.customerId().value()),
    kv("requestId",     command.requestId().value()),
    kv("previousState", before.name()),
    kv("newState",      after.name()),
    kv("paymentId",     payment.id().value())
);
Практика применения:
Если в системе несколько мест, где может произойти один и тот же переход, каждое логирует
previousState/newStateнезависимо — агент сможет отследить, через какой именно путь произошёл переход.Недопустимые переходы (нарушение инварианта состояния) логируются на уровне
ERRORс теми же полями до выброса исключения — агент получает контекст нарушения, а не только стектрейс.
Почему это важно для агента: лог с previousState и newState — это полная история жизненного цикла каждой сущности, восстанавливаемая по одному entityId. Агент может верифицировать инварианты постфактум: проверить, что все переходы соответствуют разрешённой машине состояний, выявить неожиданные пути и сформулировать гипотезу о дефекте без повторного запуска теста.
Propagation контекста между микросервисами
Анти-паттерн: каждый микросервис логирует свои requestId и бизнес-идентификаторы независимо — восстановить полную цепочку обработки запроса по логам невозможно.
Реализация:
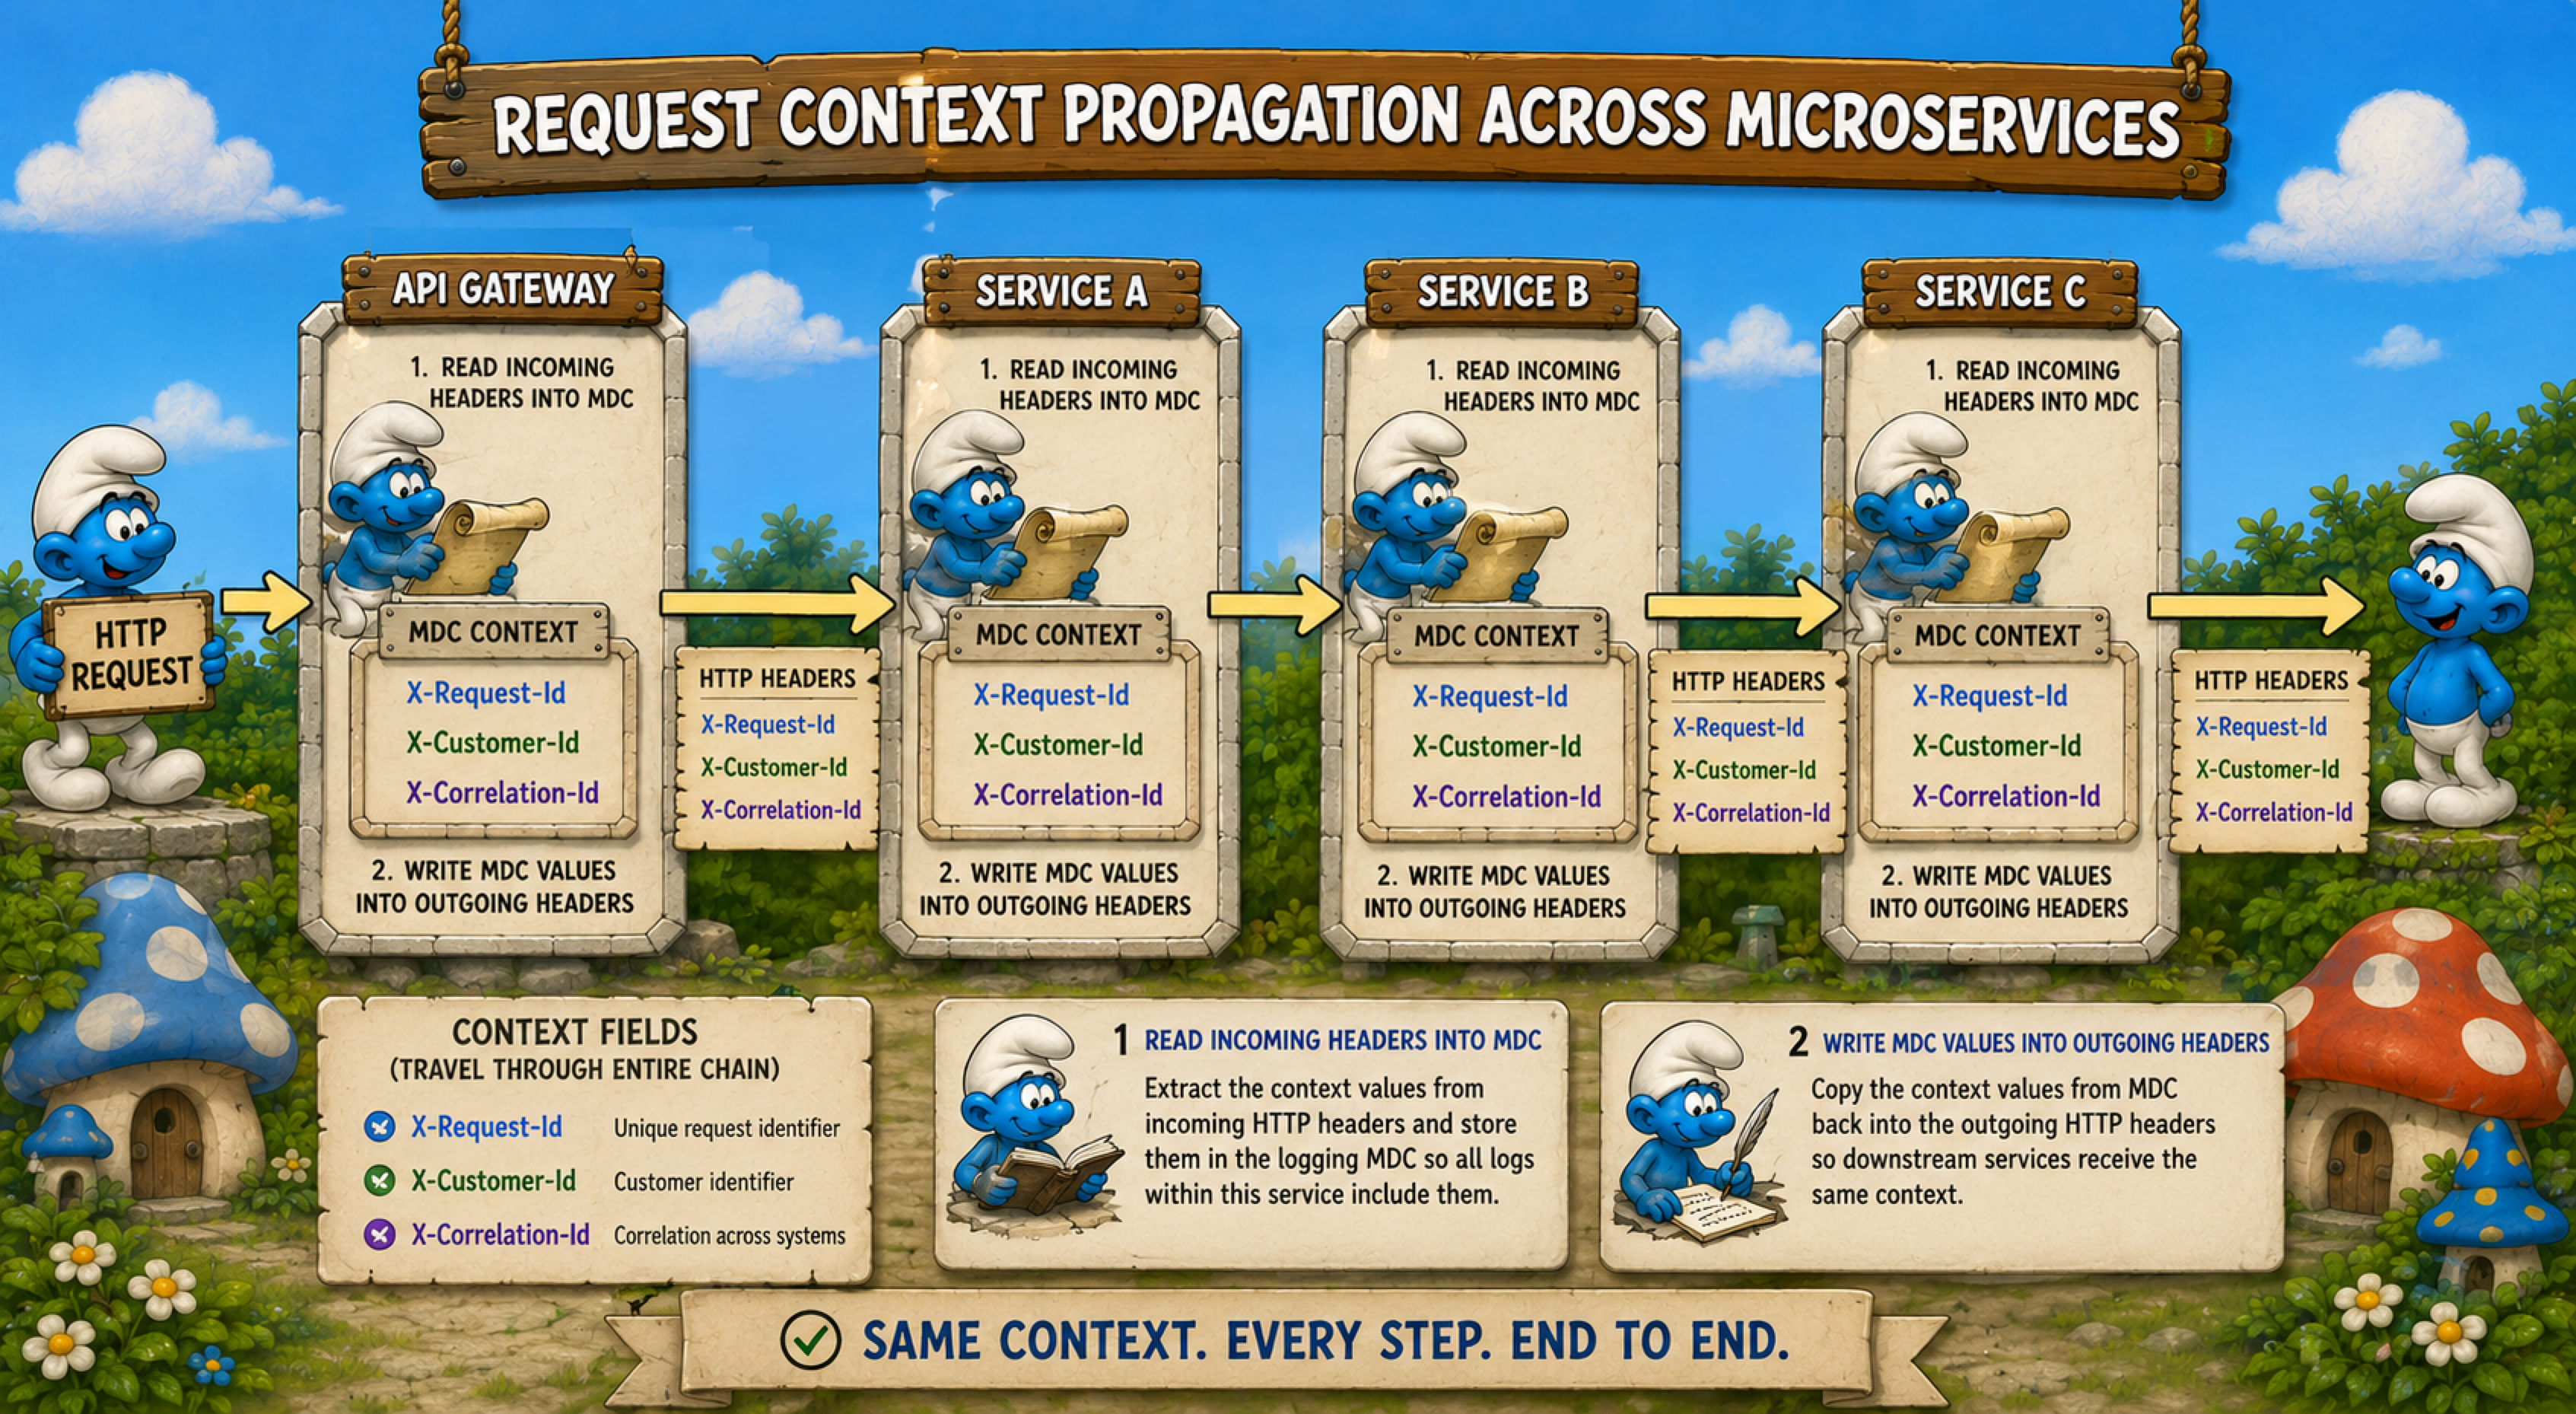
Входящий HTTP-запрос содержит заголовки с ключевыми измерениями контекста:
X-Request-Id,X-Customer-Id,X-Correlation-Idи другие значимые бизнес-идентификаторы.Servlet Filter (или
WebFilterдля реактивного стека) извлекает эти заголовки и помещает их в MDC при старте обработки запроса; при завершении — очищает MDC.При выполнении исходящего HTTP-вызова к другому микросервису значения из MDC перекладываются обратно в заголовки запроса — через
ClientHttpRequestInterceptor(RestTemplate),ExchangeFilterFunction(WebClient) или нужный механизм используемого HTTP-клиента.Принимающий микросервис повторяет ту же процедуру: заголовки → MDC.
Практика применения:
Набор propagation-заголовков фиксируется как явный контракт между сервисами и документируется наравне с API.
В Kibana или аналогичном инструменте агрегации логов фильтр по
requestIdилиcustomerIdдаёт полную картину обработки одной бизнес-операции во всех участвующих сервисах.
Почему это важно для агента: при работе с интеграционными и end-to-end тестами агент получает возможность, недоступную при разрозненном логировании, — восстановить полную причинно-следственную цепочку по единственному идентификатору.
Конкретные следствия:
Точная локализация сбоя: агент видит, на каком именно переходе между сервисами запрос изменил состояние, получил ошибку или завис — без необходимости выдвигать гипотезы о том, какой сервис «виноват».
Различение собственной ошибки и ошибки зависимости: сквозной лог показывает, вернул ли downstream-сервис ошибку, которую вышестоящий некорректно обработал, или ошибка возникла локально. Без propagation контекста эти два случая выглядят в логах одинаково.
Воспроизводимость сценария: имея полный лог одного упавшего теста, агент может восстановить точную последовательность вызовов и состояний, которая привела к сбою, и сформулировать минимально воспроизводимый сценарий для фикса или нового теста.
Отсутствие ложных исправлений: без сквозного контекста агент вынужден интерпретировать симптом (ошибку в сервисе A) как причину, тогда как реальная причина — в сервисе B, вызванном раньше. Это приводит к правкам не в том месте и регрессиям.
Перенаправление логов Testcontainers в лог теста
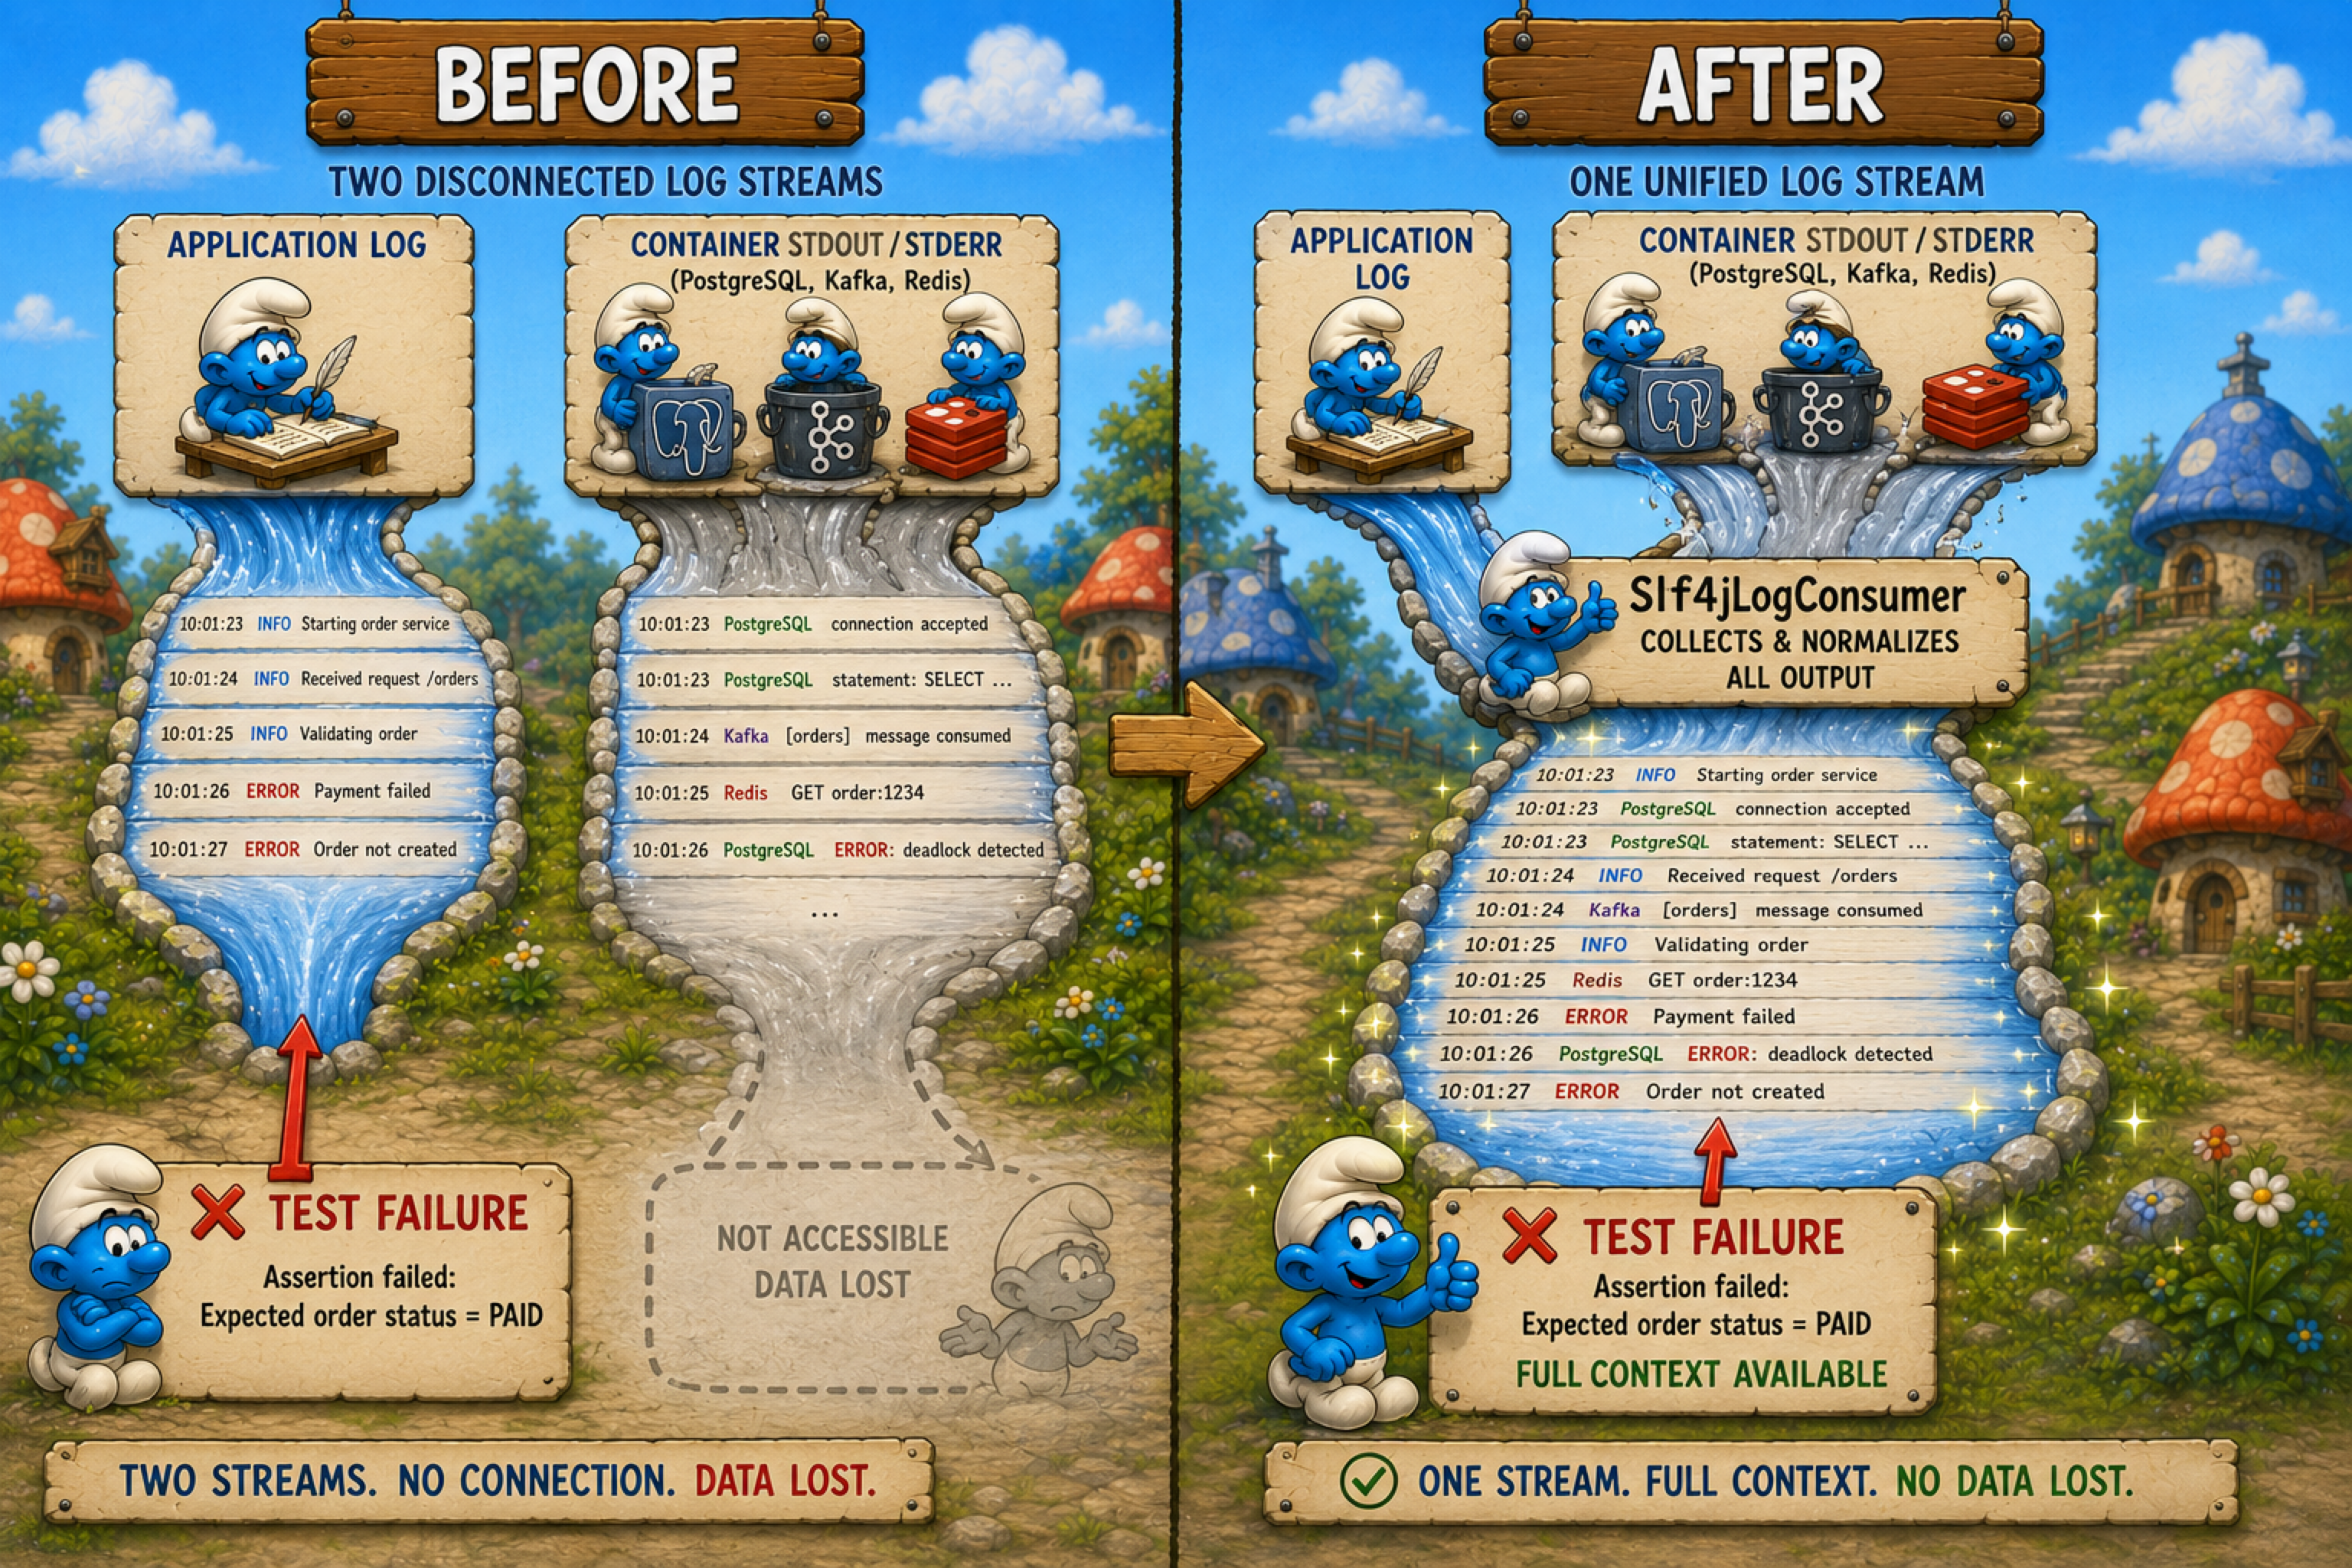
Анти-паттерн: контейнеры с зависимостями (PostgreSQL, Kafka, Redis и др.) пишут свой вывод в отдельный поток — при падении теста эта информация недоступна в общем логе и теряется.
Реализация:
Testcontainers поддерживает перенаправление stdout/stderr контейнера через
withLogConsumer(new Slf4jLogConsumer(logger))— вывод контейнера попадает в тот же Slf4j-логгер, что и лог теста. По умолчанию оба потока (stdout и stderr) выводятся на уровнеINFO; чтобы stderr отображался какERROR, используется.withSeparateOutputStreams().Логгер для каждого контейнера задаётся явно с именем, отражающим его роль (
postgres,kafka,redis), чтобы записи можно было отфильтровать.При использовании
@Containerс JUnit 5 consumer подключается в инициализаторе контейнера, до его старта.Если в проекте настроен structured logging,
Slf4jLogConsumerавтоматически наследует тот же формат — записи контейнеров появляются в том же JSON-потоке, что и записи приложения.
Практика применения:
Уровень логирования для контейнеров устанавливается отдельно от уровня приложения — обычно
DEBUGдля диагностических сессий,WARNдля штатных прогонов CI.В сочетании с паттерном «Propagation контекста между микросервисами» полный лог упавшего интеграционного теста содержит: вывод приложения, вывод всех контейнеров-зависимостей и сквозной
requestId— агент получает исчерпывающую картину без дополнительных инструментов.
Почему это важно для агента: упавший интеграционный тест порождает единый связный лог — приложение и все его зависимости в одном потоке. Агент не обязан знать, куда Docker пишет логи конкретного контейнера, и не теряет информацию из-за особенностей среды запуска. Всё, что произошло во время теста (включая сообщения об ошибках от самой СУБД, брокера или кэша), доступно там же, где результат теста.
Trace-level logging для диагностики в тестах
Анти-паттерн: логирование в тестовой среде ничем не отличается от продакшен-логирования — при падении теста в логе видны только финальные состояния и ошибки, но не промежуточные трансформации данных.
Реализация:
Для тестовой среды вводится отдельный профиль логирования с уровнем
TRACE, независимый от продакшен-конфигурации. В Spring Boot для этого есть два основных способа:logback-test.xmlвsrc/test/resources/— файл с этим именем имеет приоритет надlogback.xmlи применяется автоматически для всех тестов без дополнительной конфигурации;свойства
logging.*вapplication.propertiesвsrc/test/resources/(не вapplication-test.yml) — также применяются ко всем тестам без необходимости активировать профиль явно. Вариант сapplication-test.ymlработает только при явной активации профиляtestчерез@ActiveProfiles("test")илиspring.profiles.active=test.
На уровне
TRACEлогируются входные и выходные данные каждого значимого шага обработки: десериализованный входящий запрос, результат валидации, состояние доменного объекта до и после команды, параметры и результат каждого вызова к внешней зависимости.Trace-level logging на границах методов можно сделать автоматическим через AOP —
@Around-advice на всех бинах Spring (или на выбранных пакетах) перехватывает каждый вызов, логирует имя метода, входные аргументы и возвращаемое значение на уровнеTRACE, а исключения — на уровнеERRORс теми же структурированными полями. Это избавляет от необходимости расставлятьlog.traceвручную и гарантирует равномерное покрытие всех слоёв приложения.Все
TRACE-записи с тяжёлыми операциями сериализации оборачиваются в lazy вычисление через SLF4J 2 fluent API —log.atTrace().setMessage("state: {}").addArgument) → toJson(entity.log(). Supplier передаётся вaddArgument(Supplier<?>), и сериализация не происходит, еслиTRACEне включён. Альтернатива для кодовых баз на SLF4J 1.7 — явная проверкаif (log.isTraceEnabled()).Note
Классическая сигнатура
log.trace("state: {}", () → toJson(entity))не поддерживает ленивые вычисления. Лямбда захватывается какObject: при включённом TRACEMessageFormatterвызываетString.valueOf(arg)и в лог попадает строка видаcom.example.Foo$$Lambda$42@1540e19d, а не JSON. При выключенном TRACE форматирование не исполняется, однако добиться одновременно лени и корректного JSON-вывода через классический API невозможно в принципе. Ленивая семантика с правильным выводом доступна исключительно через fluent API:log.atTrace()…addArgument(() → …).log().Структура записей остаётся той же, что и на других уровнях: те же структурированные поля, тот же
requestId. Trace-записи отличаются только уровнем и степенью детализации payload.
Практика применения:
Trace-level logging не включается в CI по умолчанию — только при явной диагностической сессии или при падении конкретного теста.
Чувствительные данные маскируются даже в
TRACE— тестовые данные нередко попадают в артефакты сборки и системы хранения логов.
Почему это важно для агента: агент не может поставить точку останова и просматривать состояние программы в рантайме. Структурированный лог с достаточной детализацией служит для него функциональным эквивалентом отладчика — последовательность TRACE-записей описывает, как данные преобразуются на каждом шаге, где именно значение стало некорректным и какой шаг его «испортил». Чем последовательнее и полнее эти записи, тем точнее агент локализует проблему без итеративных запусков теста с добавлением новых log.debug вручную.
Sanitized stack traces
Анти-паттерн: в лог пишется полный стектрейс исключения — десятки строк вызовов платформенного кода (Spring AOP proxies, CGLIB, Groovy runtime, Servlet container), среди которых теряются две-три строки, относящиеся к коду системы.
Реализация:
Стектрейс фильтруется до строк, принадлежащих пакетам системы — например,
com.example.— плюс фиксированное количество вызовов вглубь платформы (обычно 2–3 фрейма) для сохранения точки входа в платформенный код.Полные имена пакетов в оставшихся фреймах сокращаются:
com.example.invoice.domain→invoice.domain. Для читателя и агента значим класс и метод, а не полный квалифицированный путь.Фильтрация реализуется один раз — в
@ControllerAdviceили в AOP-advice, обрабатывающем исключения, — и применяется ко всем исключениям единообразно.Полный оригинальный стектрейс при этом не теряется: он пишется отдельным полем в структурированной записи (
fullStackTrace) или сохраняется в системе агрегации логов как скрытое поле — доступен при необходимости, но не участвует в основном потоке диагностики.
Практика применения:
Список «своих» пакетов фиксируется как конфигурационный параметр, а не задаётся жёстко в логике фильтрации.
Для проектов с Groovy или Kotlin фильтрация особенно критична: рантайм этих языков добавляет в стек значительное количество синтетических фреймов, не несущих диагностической ценности.
Почему это важно для агента: стектрейс попадает в его контекстное окно наравне с остальным логом. Платформенные фреймы — это информационный шум, который не помогает локализовать проблему, но занимает место в контексте и увеличивает вероятность галлюцинации. Отфильтрованный стектрейс из пяти значимых строк даёт агенту точку отказа; полный стектрейс из шестидесяти строк размывает сигнал.
Логирование внешней активности системы
Анти-паттерн: взаимодействие системы с внешними зависимостями — СУБД, HTTP-сервисы, брокеры сообщений — не отражается в логе. При диагностике неизвестно, был ли запрос отправлен, что именно ушло и что вернулось.
Реализация:
Логируются все запросы и ответы на всех внешних границах системы:
SQL — запрос с параметрами и количество затронутых строк / размер результирующего набора;
исходящие HTTP-вызовы — метод, URL, заголовки (без секретов), тело запроса и ответа;
входящие и исходящие сообщения брокера — топик/очередь, ключ, заголовки, тело.
Если тело ответа превышает разумный порог (например, 2–4 КБ), логируется усечённая версия с явным указанием на усечение:
response truncated at 2048 bytes.Всё это логируется исключительно на уровне
TRACE— продакшен-среда работает с уровнемINFOилиWARN, и ни один из этих вызовов в штатном режиме в лог не попадает.Каждая запись содержит те же измерения propagation-контекста, что и основной лог приложения:
requestId,customerIdи другие бизнес-идентификаторы из MDC. Агент видит SQL-запрос не изолированно, а как часть конкретной бизнес-операции.Реализация централизована: перехват на уровне DataSource (например, через
datasource-proxy),ExchangeFilterFunctionдля WebClient,ClientHttpRequestInterceptorдля RestTemplate,ProducerInterceptor/ConsumerInterceptorдля Kafka — прикладной код не содержит логирующих вызовов для внешней активности.
Практика применения:
Секреты, токены и чувствительные поля маскируются до записи в лог — даже в
TRACE.Время выполнения каждого внешнего вызова логируется отдельным полем (
durationMs) — это позволяет агенту отличить логическую ошибку от деградации производительности.
Почему это важно для агента: внешняя активность системы — наиболее частый источник трудновоспроизводимых ошибок: неожиданный результат SQL-запроса, неверно сформированное HTTP-тело, сообщение с некорректным заголовком. Имея в логе точный снимок того, что ушло и что вернулось, агент может отличить ошибку в логике формирования запроса от ошибки в обработке ответа, не прибегая к гипотезам.
Логирование идемпотентности
Анти-паттерн: повторный запрос — retry после сетевого сбоя, дублирующее сообщение от брокера, повторная отправка формы — обрабатывается тихо: операция не выполняется, но в лог пишется тот же ответ 200 OK или invoice.created, что и при первичном выполнении. Агент видит в логе два одинаковых события и не может решить, была ли операция выполнена дважды или один раз.
Реализация:
Для каждой идемпотентной операции вводится отдельное имя события в словаре:
invoice.created(первичное создание) иinvoice.already_exists(повтор).При обнаружении дубликата (совпадение
idempotencyKey, конфликт уникального индекса, уже существующая запись) выполнение останавливается и логируется событие-дубль с теми же полями плюс явным флагом:kv("duplicate", true)и ссылкой на исходную операцию (kv("originalRequestId", …)).HTTP-статус при этом может оставаться
200 OK(идемпотентный ответ) — различие только в логе.
Пример реализации
Optional<Invoice> existing =
    invoiceRepository.findByIdempotencyKey(command.idempotencyKey());

if (existing.isPresent()) {
    log.info(INVOICE_ALREADY_EXISTS,
        kv("invoiceId",         existing.get().id().value()),
        kv("customerId",        command.customerId().value()),
        kv("requestId",         command.requestId().value()),
        kv("originalRequestId", existing.get().createdByRequestId()),
        kv("duplicate",         true)
    );
    return existing.get();          // возвращаем результат первичной операции
}

Invoice invoice = Invoice.create(command);
invoiceRepository.save(invoice);

log.info(INVOICE_CREATED,
    kv("invoiceId",  invoice.id().value()),
    kv("customerId", command.customerId().value()),
    kv("requestId",  command.requestId().value()),
    kv("duplicate",  false)
);
return invoice;
Практика применения:
Поле
duplicateдобавляется ко всем событиям идемпотентных операций — в том числе при первичном выполнении (duplicate: false). Это позволяет агрегировать статистику повторов без изменения схемы запроса.По
originalRequestIdагент находит исходный запрос и проверяет, что первичная операция завершилась успешно.
Почему это важно для агента: без явного различения агент считает каждое вхождение invoice.created новой операцией — и ошибочно делает вывод о двойном выполнении или некорректном подсчёте. Явный duplicate: true снимает неопределённость: агент точно знает, что операция отклонена как дубликат, и не инициирует исправление несуществующего дефекта.
Динамическое включение TRACE для конкретного клиента
Анти-паттерн: TRACE включается глобально для всего сервера — объём лога резко возрастает для всех клиентов одновременно, что создаёт нагрузку на инфраструктуру логирования и засоряет контекст агента нерелевантными записями.
Реализация:
Два механизма дополняют друг друга:
/actuator/loggers — глобальное переключение на уровне пакета. Spring Boot Actuator предоставляет эндпоинт POST /actuator/loggers/{loggerName} с телом {"configuredLevel":"TRACE"}, который динамически меняет уровень логирования для указанного пакета без перезапуска сервера. Изменение действует на весь JVM-процесс в течение его жизненного цикла и сбрасывается через POST {"configuredLevel": null} — значение null возвращает логгер к конфигурации по умолчанию. После перезапуска JVM уровни восстанавливаются из application.properties или Logback-конфигурации. Успешный POST возвращает HTTP 204 No Content. Этот механизм подходит для коротких диагностических сессий «включить TRACE на один пакет, посмотреть, выключить», но не решает задачу изоляции одного клиента.
Note | Эндпоинт |
MDC + Logback TurboFilter — истинная per-request изоляция. Единственный механизм в Logback, дающий TRACE для конкретного запроса без изменения глобального уровня. Архитектурная основа: Logback вычисляет цепочку TurboFilter’ов до проверки effective level логгера, и ответ ACCEPT от TurboFilter полностью обходит эту проверку. Таким образом, TRACE-событие проходит в appender, даже если глобальный уровень установлен в INFO.
Цепочка принятия решений при per-request TRACE:
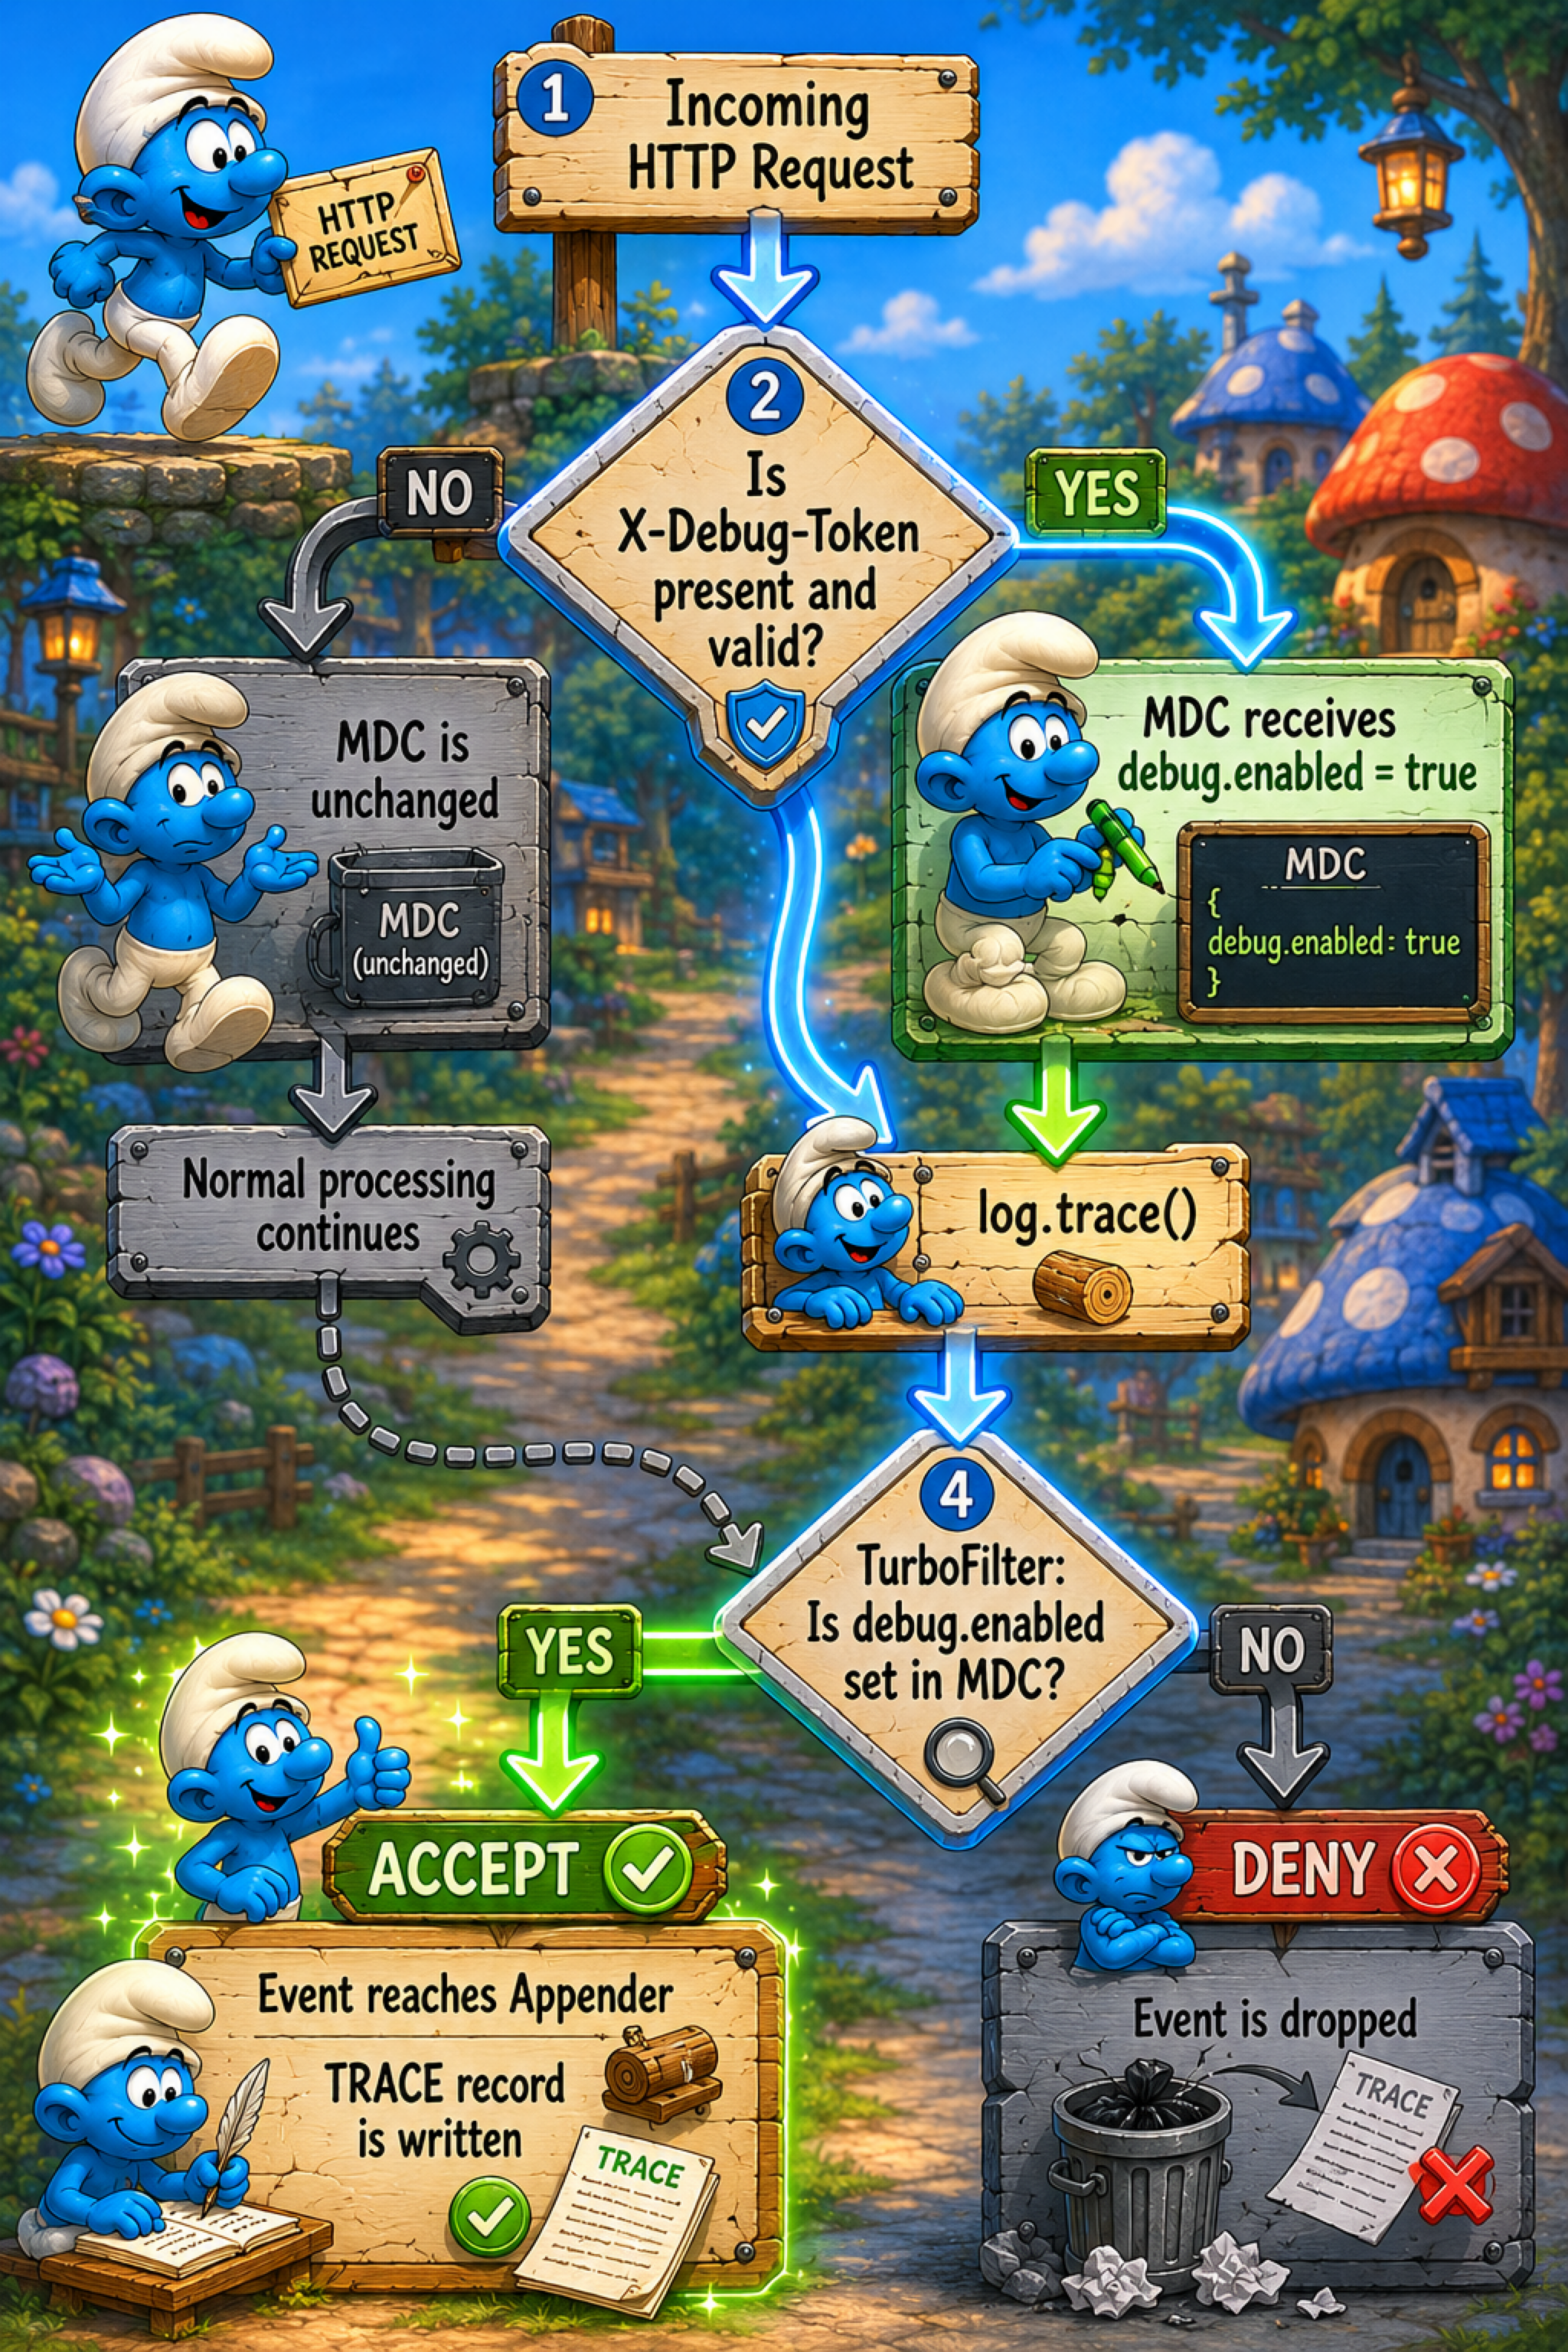
Реализация складывается из трёх компонентов:
Servlet Filter (
OncePerRequestFilter) извлекает из входящего запроса заголовок (например,X-Debug-Token), верифицирует его подпись (HMAC-SHA256 или короткоживущий JWT) и при успехе выполняетMDC.put("debug.enabled", "true"). Очистка — строго в блокеfinally.TurboFilter в
logback-spring.xmlчитает MDC-ключdebug.enabledи возвращаетACCEPTдля TRACE-событий, когда флаг установлен. Logback поставляет готовыйDynamicThresholdFilter, который реализует именно эту логику без дополнительного кода:<turboFilter class="ch.qos.logback.classic.turbo.DynamicThresholdFilter"> <Key>debug.enabled</Key> <DefaultThreshold>INFO</DefaultThreshold> <OnHigherOrEqual>NEUTRAL</OnHigherOrEqual> <OnLower>DENY</OnLower> <MDCValueLevelPair> <value>true</value> <level>TRACE</level> </MDCValueLevelPair> </turboFilter>Для гранулярного управления — например, включать TRACE только для пакетов собственной системы — пишется кастомный TurboFilter: в методе
decide()выполняетсяMDC.get("debug.enabled")плюс проверкаlogger.getName().startsWith("com.example"), что исключает из TRACE платформенный код.Propagation через потоки. MDC не передаётся автоматически при переключении потока. Для
ThreadPoolTaskExecutorнеобходимTaskDecorator, копирующий контекст MDC в рабочий поток. Для реактивного стека (WebFlux) — Micrometer Context Propagation (io.micrometer:context-propagation≥ 1.0.3, Reactor Core ≥ 3.5.3) сThreadLocalAccessorдля ключей MDC и вызовHooks.enableAutomaticContextPropagation()при старте приложения.
Per-user TRACE через идентификатор сессии. Альтернативный сценарий: TRACE включается не по оператору через X-Debug-Token, а для конкретного аутентифицированного пользователя системы. Механика та же — MDC + TurboFilter — но источник флага другой.
Servlet Filter (или Spring Security AuthorizationFilter) после успешной аутентификации проверяет, входит ли userId текущего пользователя в хранимый список «пользователей под наблюдением» (in-memory Set, обновляемый через отдельный admin-эндпоинт или feature-flag сервис), и при совпадении выполняет MDC.put("debug.enabled", "true"). TurboFilter при этом не меняется — он по-прежнему читает тот же MDC-ключ.
Список наблюдаемых пользователей управляется через защищённый admin-эндпоинт:
@RestController
@RequestMapping("/admin/debug-users")
@PreAuthorize("hasRole('LOG_ADMIN')")
public class DebugUserController {

    private final Set<String> debugUsers = ConcurrentHashMap.newKeySet();

    @PutMapping("/{userId}")
    public void enable(@PathVariable String userId) {
        debugUsers.add(userId);
    }

    @DeleteMapping("/{userId}")
    public void disable(@PathVariable String userId) {
        debugUsers.remove(userId);
    }

    public boolean isEnabled(String userId) {
        return debugUsers.contains(userId);
    }
}
Этот подход особенно удобен, когда проблема воспроизводится только у конкретного пользователя в продакшене и требует наблюдения в реальном сеансе работы, а не в искусственном тестовом сценарии.
Практика применения:
Токены для заголовка
X-Debug-Tokenвыпускаются оператором через отдельный защищённый инструмент; время жизни — не более 30 минут; область действия ограничена конкретнымcustomerIdилиcorrelationId.Заголовок
X-Debug-Tokenудаляется на API-шлюзе из всех запросов, кроме исходящих из операторского инструментария.Вызов
SecurityContextHolder.getContext()внутри TurboFilter недопустим. Начиная со Spring Security 5.8SecurityContextинициализируется лениво черезSupplierDeferredSecurityContext. Обращение к нему из TurboFilter в процессе аутентификации вызывает TRACE-лог внутриHttpSessionSecurityContextRepository.readSecurityContextFromSession(), который снова запускает TurboFilter до завершения инициализации контекста — возникает бесконечная рекурсия, завершающаясяStackOverflowError(см. spring-projects/spring-security#14338). Идентификатор пользователя помещается в MDC в Servlet Filter и читается оттуда в TurboFilter./actuator/loggersзакрывается ролью и выносится на отдельный management-порт, недоступный извне кластера.
Почему это важно для агента: агент может самостоятельно инициировать диагностическую сессию — запросить токен, передать заголовок в тестовом или интеграционном сценарии и получить полный TRACE-лог только для интересующей операции, не создавая помех остальному трафику. Это превращает динамическое логирование из ручной операции оператора в автоматизируемый инструмент диагностики.
Машиночитаемый итог тестового прогона
Анти-паттерн: агент определяет результат тестового прогона, разбирая вывод JUnit — строки вида Tests run: 42, Failures: 1, Errors: 0 — или сканируя весь лог в поисках слова FAILED. При нескольких сотнях тестов и многоуровневом логировании это ненадёжно: формат вывода зависит от плагина сборки, агрегатора логов и настроек CI.
Реализация:
После завершения каждого интеграционного или end-to-end теста в лог пишется структурированная итоговая запись с предсказуемым именем события и фиксированным набором полей.
Запись пишется в
@AfterEach-методе базового тестового класса или через JUnit 5TestWatcherextension — один раз для всего проекта.Поля итоговой записи:
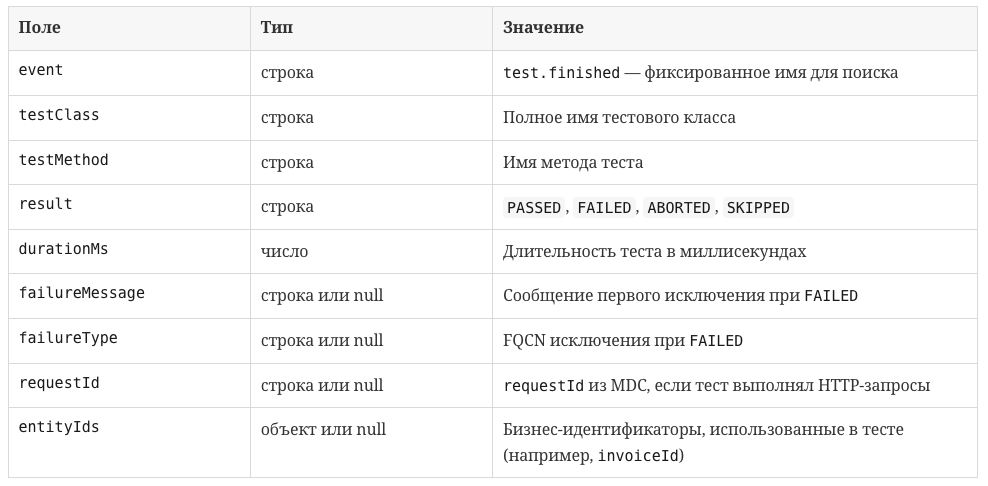
Пример реализации через JUnit 5 TestWatcher
public class StructuredTestWatcher implements TestWatcher {

    private static final Logger log =
        LoggerFactory.getLogger(StructuredTestWatcher.class);

    @Override
    public void testSuccessful(ExtensionContext context) {
        writeResult(context, "PASSED", null);
    }

    @Override
    public void testFailed(ExtensionContext context, Throwable cause) {
        writeResult(context, "FAILED", cause);
    }

    @Override
    public void testAborted(ExtensionContext context, Throwable cause) {
        writeResult(context, "ABORTED", cause);
    }

    @Override
    public void testDisabled(ExtensionContext context, Optional<String> reason) {
        writeResult(context, "SKIPPED", null);
    }

    private void writeResult(ExtensionContext ctx, String result, Throwable cause) {
        // import static net.logstash.logback.argument.StructuredArguments.kv;
        log.info("test.finished",
            kv("testClass",      ctx.getRequiredTestClass().getName()),
            kv("testMethod",     ctx.getRequiredTestMethod().getName()),
            kv("result",         result),
            kv("failureMessage", cause != null ? cause.getMessage()           : null),
            kv("failureType",    cause != null ? cause.getClass().getName()   : null),
            kv("requestId",      MDC.get("requestId"))
        );
    }
}
Подключение в базовом тестовом классе
@ExtendWith(StructuredTestWatcher.class)
public abstract class BaseIntegrationTest {
    // общая конфигурация контекста
}
Практика применения:
Агент находит итог любого теста одним запросом к логу:
message: "test.finished" AND testMethod: "shouldCreateInvoice"— без парсинга вывода сборщика.При
result: "FAILED"агент немедленно получаетfailureTypeиfailureMessage, а поrequestId— полный TRACE-лог того же запроса. Всё необходимое для диагностики доступно в трёх полях одной записи.Поле
durationMsпозволяет агенту самостоятельно выявлять деградацию производительности без анализа временны́х меток: тест, выполнявшийся 200 мс и внезапно занявший 8 секунд, виден в агрегации сразу.
Почему это важно для агента: итоговая запись — это точка входа в диагностику. Вместо того чтобы сканировать тысячи строк в поисках FAILED, агент фильтрует test.finished с result: "FAILED" и получает список упавших тестов с полным контекстом. Это меняет характер работы: вместо поиска проблемы агент сразу переходит к её анализу.
Спецификация по наблюдаемому поведению
Анти-паттерн: спецификация use case описывает намерение разработчика на момент написания и никогда не обновляется по результатам реального поведения системы. Со временем расхождение между спецификацией и реализацией накапливается незаметно.
Реализация:
Если лог содержит достаточно структурированной информации о поведении системы (входные данные, переходы состояний, результаты, ошибки), агент способен не только искать дефекты, но и реконструировать спецификацию use case по наблюдаемому поведению — и сравнить её с исходной.
Рабочий цикл:
Агент запускает тесты и собирает структурированный лог выполнения.
По логу агент формулирует спецификацию: что принимается на вход, какие состояния проходит сущность, какие условия приводят к ошибкам, какие инварианты соблюдаются фактически.
Агент сравнивает реконструированную спецификацию с исходной (например,
CLAUDE.mdв корне функционального модуля) и фиксирует расхождения: что реализовано иначе, что появилось, что исчезло.Спецификация обновляется — не по намерению, а по факту.
На следующем витке разработки цикл повторяется: изменения в поведении системы отражаются в спецификации явно, а не теряются в истории коммитов.
Практика применения:
Спецификация хранится рядом с кодом модуля в системе контроля версий — её история изменений отражает реальное поведение системы, а не намерения.
Расхождение между реконструированной и исходной спецификацией становится артефактом ревью: оно требует явного решения — обновить спецификацию, исправить реализацию или зафиксировать намеренное отклонение.
Формат спецификации выбирается исходя из удобства чтения агентом и человеком одновременно: структурированный текст (Markdown, AsciiDoc) предпочтительнее свободного текста — агенту легче находить конкретные утверждения для сравнения.
Почему это важно для агента: агент работает с тем, что наблюдаемо, а не с тем, что задумано. Актуальная спецификация, отражающая реальное поведение, — это точная карта системы, по которой агент ориентируется при внесении изменений. Устаревшая спецификация — источник галлюцинаций: агент воспроизводит задокументированное поведение, которого в системе уже нет.
Git-история как лог проекта
Git-история — это тоже лог. Не runtime-лог приложения, но лог примерно в том же смысле: хронологически упорядоченная, append-only последовательность записей о том, что происходило с системой.
Каждый коммит — это запись с временной меткой, автором, описанием изменения и ссылкой на предыдущее состояние.
Как и runtime-лог, git-история читается в двух режимах: человеком при ревью и инструментом при поиске причины сбоя.
Но в отличие от runtime-лога, git-история фиксирует не поведение системы в продакшене, а эволюцию её знаний о самой себе:
почему появился этот метод;
какой баг заставил добавить этот guard;
почему контракт API выглядит именно так, а не иначе.
Это база знаний о намерениях — информация, которая нигде больше не хранится явно.
Для агента git-история — источник контекста, недоступный из текущего состояния кода. Код отвечает на вопрос «как», git-история отвечает на вопрос «почему».
Агент, который читает только код, видит конечное состояние без истории решений, которые к нему привели.
Агент, который умеет читать
git log, работает с полной картиной: он видит, какие альтернативы уже были отвергнуты, какие инварианты намеренно поддерживаются, какие изменения были сделаны в ответ на конкретные баги.
Без этого контекста агент воспроизводит отвергнутые решения, нарушает незадокументированные инварианты и «изобретает» подходы, которые уже проверялись и не сработали.
Эмпирически эффект подтверждён:
Microsoft Research в препринте Code Researcher (Singh et al., arXiv:2506.11060, июнь 2025) показала, что агент, использующий commit-историю как источник рассуждений, поднимает процент успешно разрешённых крэш-патчей Linux-ядра на бенчмарке kBenchSyz с 37,5 % до 58 % (конфигурация: GPT-4o, 5 траекторий) — без каких-либо изменений в модели.
CMU в работе по repository-level retrieval (Gandhi, Gao, Callan, arXiv:2502.07067, февраль 2025) зафиксировала рост MAP/MRR/P@1 до 80 % при поиске по commit-сообщениям с neural reranking против baseline BM25. Разница определяется не моделью, а качеством исторического контекста.
Оба результата опубликованы как препринты arXiv и не прошли рецензирование на момент написания. Их следует трактовать как предварительные данные.
Паттерны этой группы делают git-историю читаемой для агента — так же, как паттерны runtime-логирования делают читаемым поведение системы в продакшене.
Conventional Commits: структурированный формат записи
Анти-паттерн: сообщения коммитов пишутся в произвольном формате — "update files", "fix", "WIP", "changes", "it works". Агент не может классифицировать намерение, не читая весь diff; не может найти все коммиты одного типа; не может определить, было ли изменение новой функциональностью, исправлением бага или рефакторингом.
Реализация:
Принимается спецификация Conventional Commits 1.0.0 как обязательный формат для всех коммитов в main-ветку. Формат:
<тип>[область]: <описание>.Спецификация 1.0.0 обязывает использовать два типа —
feat(новая функциональность) иfix(исправление бага). Остальные типы —refactor(рефакторинг без изменения поведения),test(тесты),docs(документация),perf(производительность),build(сборка),ci(CI/CD),chore(обслуживание) — закреплены Angular-конвенцией и пакетом@commitlint/config-conventional; спецификация допускает их использование, но не требует.Область (
scope) — имя модуля или компонента в скобках после типа:feat(payments),fix(auth),refactor(invoice-domain). Агент сопоставляет область с файловой структурой репозитория без анализа diff.Breaking change обозначается восклицательным знаком после типа/области (
feat(api)!) или трейлеромBREAKING CHANGE:в теле. Это сигнал для агента, что публичный контракт нарушен.commitlint+ pre-commit hook через Husky илиlefthookавтоматически проверяет формат каждого коммита до его записи в историю.
Пример: плохо и хорошо
# Плохо — агент не знает, что произошло
update files
fix bug
WIP
asdf

# Хорошо — тип, область, намерение читаются без diff
feat(payments): add idempotency key validation on charge endpoint
fix(cache): prevent stale invoice state after partial reload
refactor(parser): extract token-stream into InvoiceTokenizer class
perf(reports): replace N+1 query with single JOIN in monthly aggregate

feat(api)!: remove v1 invoice endpoints

BREAKING CHANGE: /v1/invoices/* routes now return 410 Gone.
Clients must migrate to /v2/invoices/*.
Пример конфигурации commitlint
// .commitlintrc.json
{
  "extends": ["@commitlint/config-conventional"],
  "rules": {
    "scope-enum": [2, "always", [
      "auth", "payments", "invoices", "cache", "reports", "api", "build", "ci"
    ]],
    "subject-max-length": [2, "always", 72]
  }
}
Практика применения:
Subject-строка пишется в повелительном наклонении:
"Add", а не"Added"или"Adding". Тест: «если применить этот коммит, он » — фраза должна читаться естественно.Subject ≤ 72 символов — это не эстетика, а функциональное ограничение:
git log --oneline, GitHub Releases, терминал без переноса строки.Если в коммит не укладывается одна осмысленная фраза — скорее всего, коммит не атомарный (см. следующий паттерн).
Почему это важно для агента: агент классифицирует намерение без чтения diff. feat(payments): немедленно сообщает: «новая функциональность в платёжном модуле». fix(cache): — «исправление в слое кэширования». По типу и области агент фильтрует релевантную историю (git log -P --grep="^fix\(payments\)") и решает, куда вносить изменение, не читая весь репозиторий.
Note | Скобки в |
Именование веток: машиночитаемый контекст до первого коммита
Анти-паттерн: ветки называются произвольно — feature-1, fix, alice-work, new-stuff, tmp. Агент, приступающий к задаче, выполняет git log main..HEAD --oneline и видит имя ветки как первый контекст — ещё до чтения единственного коммита. Произвольное имя не даёт ничего: агент не знает ни намерения, ни затронутой области, ни типа изменения.
Реализация:
Ветка называется по схеме
<тип>/<область>/<краткое-описание>, где тип и область совпадают с типом и scope из Conventional Commits:feat/payments/idempotency-key,fix/cache/stale-invoice,chore/ci/release-workflow,refactor/invoice/status-enum.Разделитель внутри описания — дефис, строчные буквы, без пробелов. Максимальная длина — 40 символов: имя ветки появляется в заголовках PR, в
git branch -a, в логах CI.Тип в имени ветки — тот же, что будет в итоговом squash-коммите. Это создаёт согласованность: если ветка
feat/…, в main попадает коммитfeat(…):; несоответствие — сигнал о неверной классификации.Конвенция фиксируется в
.commitlintrc.jsonчерез правилоbranch-name-pattern(плагин@commitlint/cz-conventional-changelog) или в CI-проверке отдельным шагом:
Пример: проверка имени ветки в GitHub Actions
# .github/workflows/branch-check.yml
name: Branch name
on: [push, pull_request]
jobs:
  check:
    runs-on: ubuntu-latest
    steps:
      - name: Validate branch name
        run: |
          BRANCH="\({GITHUB_HEAD_REF:-\){GITHUB_REF#refs/heads/}}"
          # main, develop, release/*, hotfix/* — допустимые исключения
          if [[ "\(BRANCH" =~ ^(main|develop|release/.+|hotfix/.+)\) ]]; then
            exit 0
          fi
          # feature-ветки: feat|fix|refactor|test|docs|perf|build|ci|chore
          PATTERN='^(feat|fix|refactor|test|docs|perf|build|ci|chore)\/[a-z0-9-]+\/[a-z0-9-]{1,40}$'
          if ! [[ "\(BRANCH" =~ \)PATTERN ]]; then
            echo "Branch '$BRANCH' does not match <type>/<scope>/<description>"
            echo "Example: feat/payments/idempotency-key"
            exit 1
          fi
Пример: плохо и хорошо
# Плохо — агент не знает ни намерения, ни области до чтения коммитов
feature-1
alice-fix
new-stuff
tmp-2

# Хорошо — тип, область и намерение читаются из имени ветки
feat/payments/idempotency-key
fix/cache/stale-invoice-after-reload
refactor/invoice/replace-string-status-with-enum
chore/ci/add-semantic-release-workflow
Практика применения:
Имя ветки — первый элемент контекста агента при
git log main..HEAD. Когда агент читаетfeat/payments/idempotency-key, он уже знает: это новая функциональность в платёжном модуле, связанная с ключами идемпотентности. Первый коммит только подтверждает это.Шаблон PR-заголовка в GitHub (
Settings → General → Pull Request → Default title) стоит настроить как{branch}или использоватьfeat(payments): …вручную — имя ветки уже содержит всю нужную информацию для автоматической подстановки.release/иhotfix/— допустимые исключения из схемы; их смысл общепонятен без дополнительной классификации.
Почему это важно для агента: имя ветки — это заголовок записи в логе ещё до того, как запись сделана. Агент, начинающий работу в ветке feat/payments/idempotency-key, немедленно понимает контекст задачи, не читая ни одного коммита, ни одного файла. Это снижает число ошибочных предположений о намерении в самом начале сессии — до того, как агент успел внести какие-либо изменения.
Атомарные коммиты: одно логическое изменение — один коммит
Анти-паттерн: один коммит смешивает несколько несвязанных изменений — логирование, пагинацию и фильтрацию в одном диффе; рефакторинг метода и новый бизнес-сценарий в одном commit’е. При git bisect или git revert агент вынужден работать с блоком кода, в котором переплетены несвязанные изменения.
Реализация:
Коммит содержит одно логическое изменение: он отвечает на один вопрос «что изменилось и зачем». Если subject требует союза «и», коммит нужно разбить.
Каждый коммит оставляет репозиторий в рабочем состоянии: код собирается, тесты проходят. Это контракт, необходимый для работы
git bisect.Для стейджинга по частям используется
git add -p(интерактивный выбор hunk’ов) илиgit add -e(редактирование patch вручную).Если изменения уже перемешаны в working tree —
git stashдля временного сохранения, затем поэтапный commit.
Пример: плохо — три аспекта в одном коммите
# Один коммит трогает config.py, models.py, server.py
# по причинам: пагинация, логирование, фильтрация активных пользователей.
# Сообщение: "add pagination and logging and user filter"
#
# git log --oneline видит:
7a3f2b1 add pagination and logging and user filter
#
# git bisect приземляется сюда — агент читает +300/-120 строк
# и не может определить, какая из трёх причин вызвала регрессию.
Пример: хорошо — три атомарных коммита
# git log --oneline видит:
c4e1d09 feat(users): filter inactive accounts from list endpoint
b2f7a13 feat(users): add cursor-based pagination to list endpoint
8d3e421 feat(users): emit user.listed event with result count

# git bisect приземляется на один коммит с +40/-15 строк.
# Агент читает один логический change и немедленно понимает причину.
Пример: разбить уже написанный коммит
# Ситуация: последний коммит смешал пагинацию и логирование.
# Разбиваем через interactive rebase:
git rebase -i HEAD~1          # пометить коммит как 'edit'
git reset HEAD^               # mixed reset: индекс сброшен, файлы остались
git add -p src/UserService.java   # выбрать только hunk'и пагинации
git commit -m "feat(users): add cursor-based pagination to list endpoint"
git add src/UserService.java      # остаток — логирование
git commit -m "feat(users): emit user.listed event with result count"
git rebase --continue
Практика применения:
Правило «коммит должен собираться» проверяется в CI: если ветка содержит коммит, на котором тесты не проходят, PR не принимается. Это заставляет разработчика думать об атомарности ещё до push.
Мелкие исправления в ответ на ревью коммитятся через
git commit --fixup=<sha>и впоследствии сворачиваются в базовый коммит черезgit rebase --autosquash— история остаётся атомарной после итеративной работы.
Почему это важно для агента: git bisect — инструмент бинарного поиска регрессии по истории коммитов. Он работает только если каждый коммит самодостаточен и верифицируем. При атомарных коммитах агент автоматизирует bisect: запускает тест на каждом коммите и за O(log n) шагов находит точный коммит-причину. При неатомарных коммитах bisect бессмысленен — агент приземляется на блок из 300 строк с тремя несвязанными изменениями и начинает угадывать.
git bisect run: автоматизированный поиск регрессии
Ручной bisect требует, чтобы разработчик на каждом шаге запускал тест и отвечал git bisect good / git bisect bad. Агент заменяет этот цикл командой git bisect run <скрипт>: git автоматически проходит все шаги, вызывая скрипт на каждом коммите и интерпретируя код возврата (0: хороший коммит; 1–127: плохой коммит; 125: коммит пропускается).
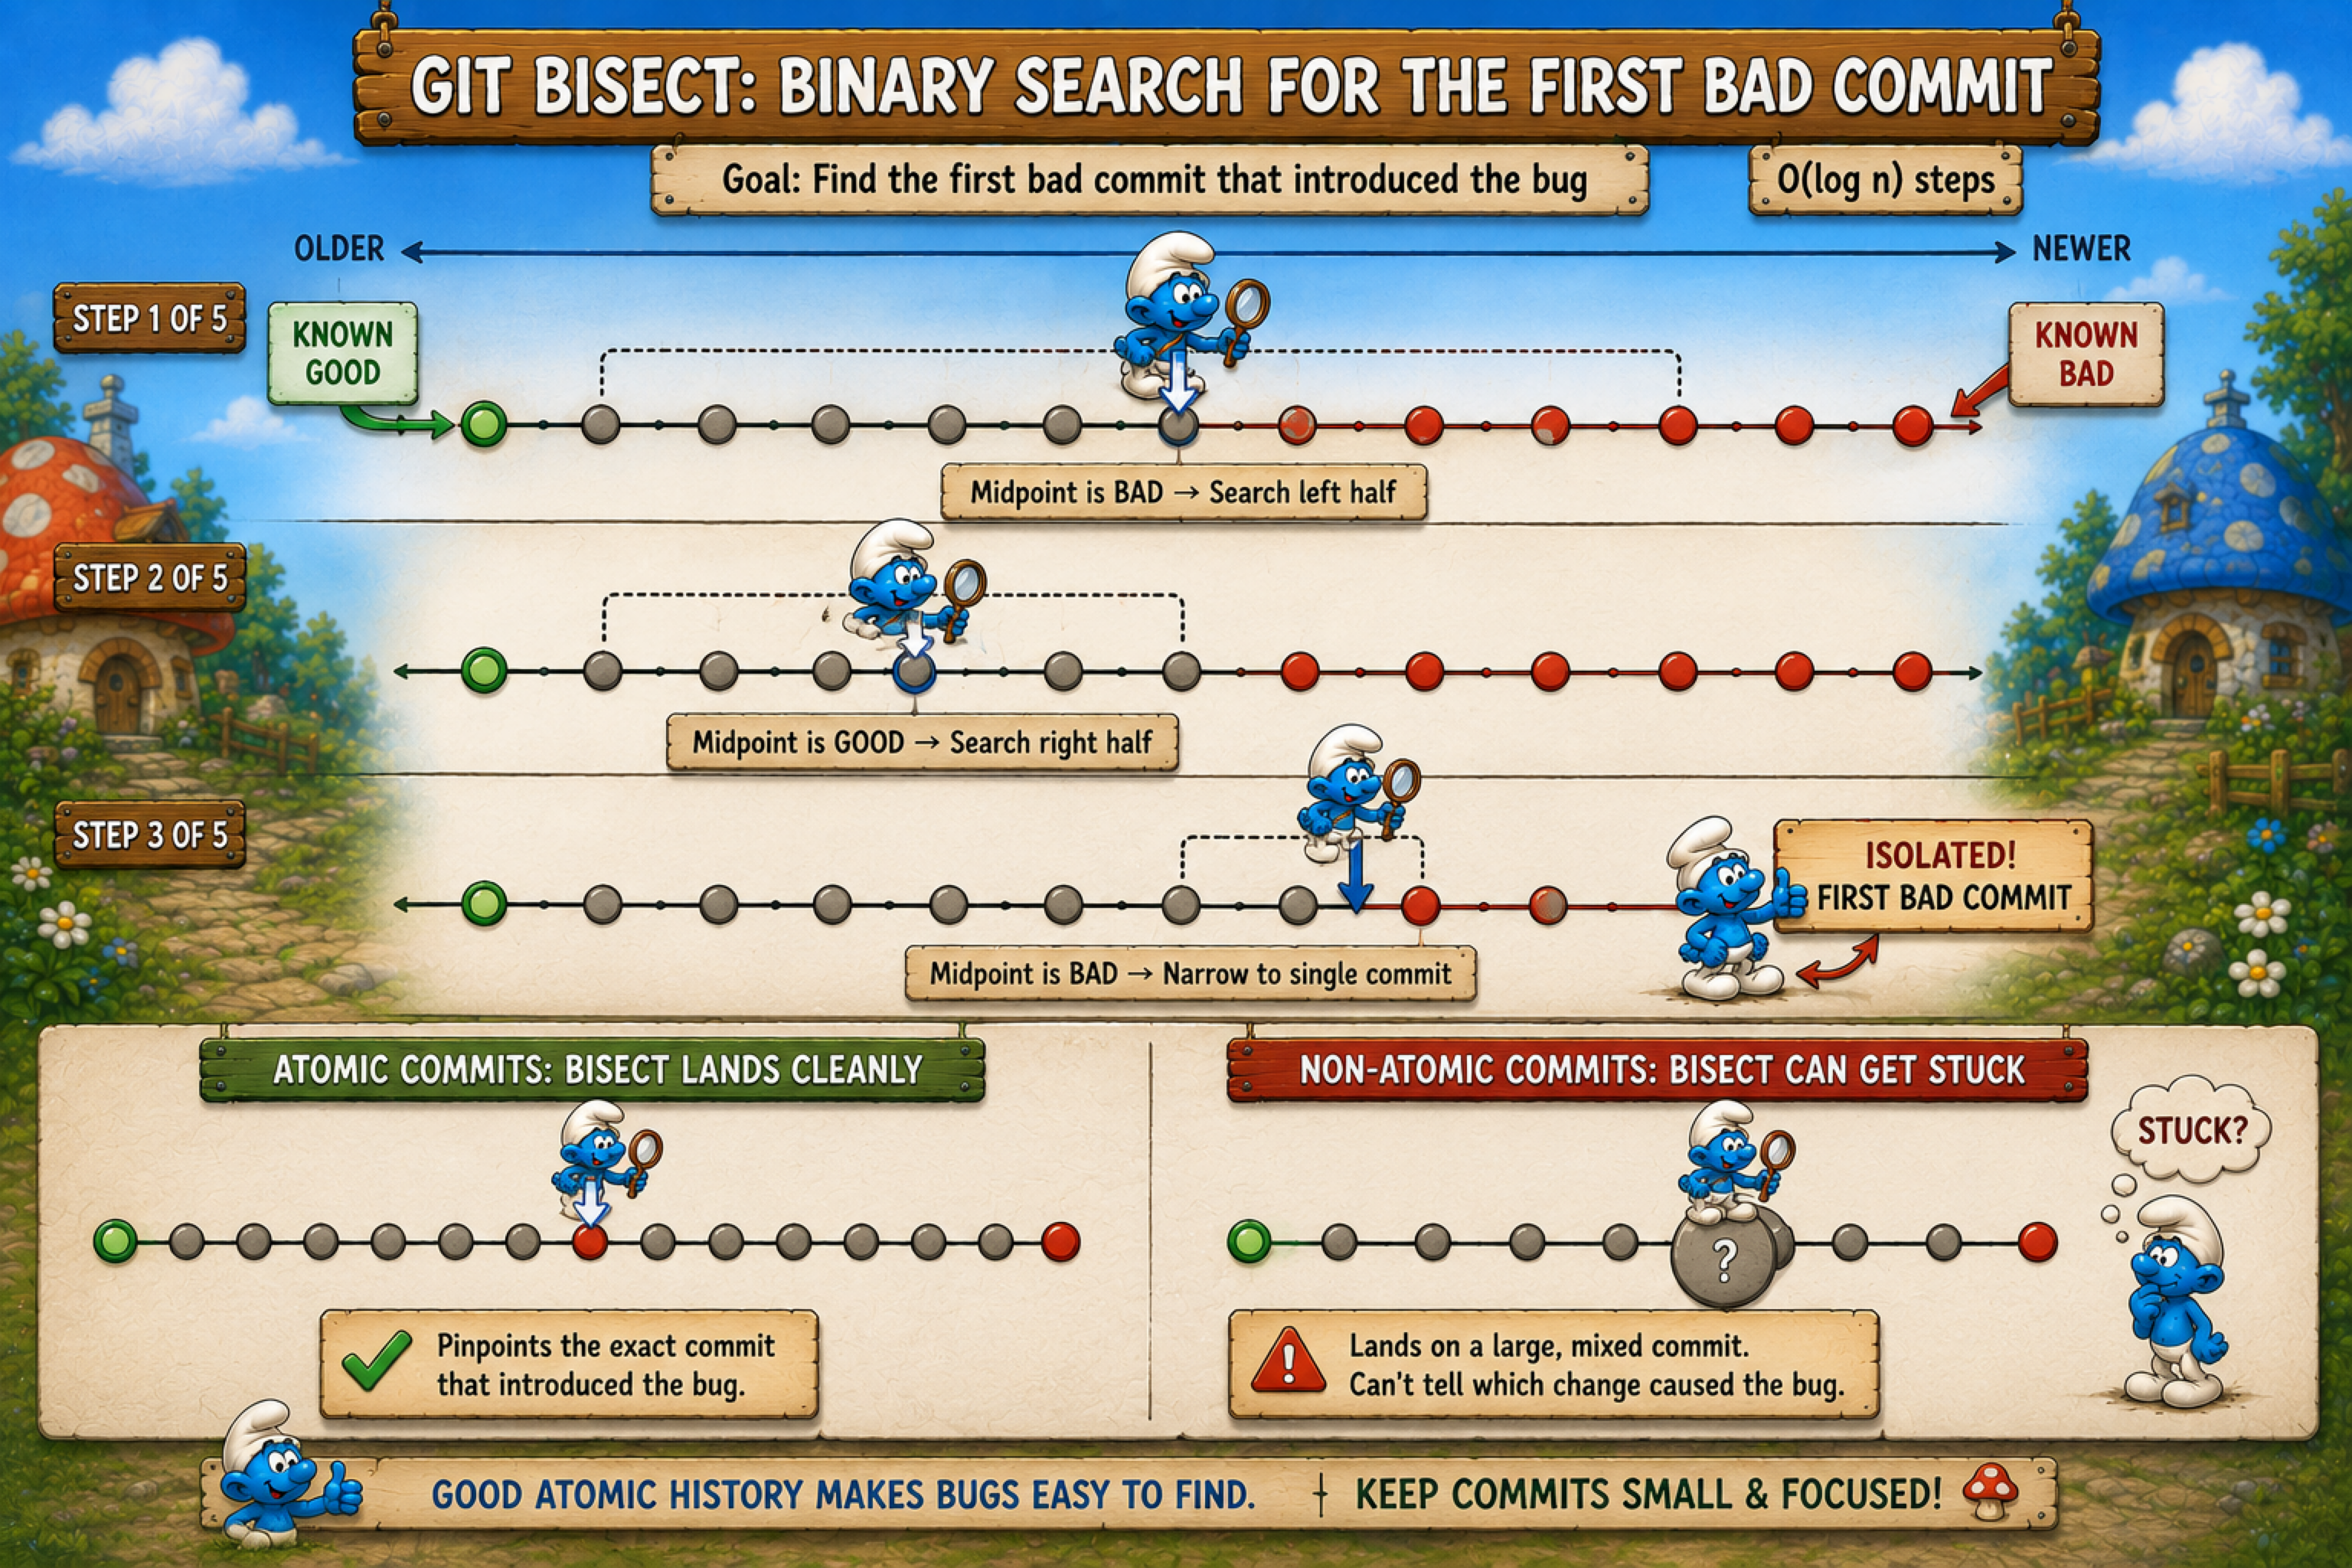
Пример: найти коммит, сломавший тест
# Инициализировать bisect: задать границы поиска
git bisect start
git bisect bad HEAD                  # текущий коммит — сломан
git bisect good v2.3.1               # тег релиза, где всё работало

# Передать скрипт-верификатор — git сам пройдёт O(log n) шагов
git bisect run ./scripts/verify-regression.sh

# Результат:
# b2f7a13 is the first bad commit
# feat(users): add cursor-based pagination to list endpoint
# ...
git bisect reset                     # вернуться на HEAD
Пример: скрипт-верификатор для Java-проекта (Maven)
#!/bin/sh
# scripts/verify-regression.sh
# Возвращает 0 (хороший коммит) или 1 (плохой коммит).
# Возвращает 125, если коммит не компилируется (пропустить).

set -e

# Проверить, компилируется ли коммит
mvn compile -q 2>/dev/null || exit 125

# Запустить конкретный тест, выявляющий регрессию
mvn test -pl invoices -Dtest=InvoiceListIT#testPaginationDoesNotSkipRecords \
    -q 2>/dev/null
# mvn возвращает 0 при успехе, ненулевой код при ошибке —
# git bisect интерпретирует это напрямую
Note | Скрипт должен быть идемпотентным и не зависеть от внешнего состояния — bisect checkout’ит каждый коммит в чистое дерево. Если тест требует миграции БД, добавьте |
Практика применения для агента:
Агент пишет скрипт-верификатор под конкретную регрессию: берёт failing-тест из CI, оборачивает в sh-скрипт с нужными флагами, передаёт в
git bisect run. Человек получает SHA первого сломанного коммита без ручного перебора.git bisect runработает корректно только при атомарных коммитах: если коммит не компилируется — возвращать 125 (skip), а не 1. Агент должен включать проверку компиляции перед запуском теста.После нахождения коммита агент читает его тело (
git show <sha>) — именно здесь раздел «Considered / Rejected» из паттерна «Тело коммита» становится ответом на вопрос «почему это было сделано именно так».
Тело коммита: «почему», а не «что»
Анти-паттерн: тело коммита либо отсутствует, либо пересказывает то, что и так видно в диффе — «добавил метод validate()», «изменил поле status с String на enum». Это дублирование: diff уже показывает «что». Теряется единственная информация, которой нет в коде, — намерение, контекст и отвергнутые альтернативы.
Реализация:
Subject-строка называет «что» (одна фраза). Тело объясняет «почему»: симптом или ограничение, которое заставило сделать это изменение; вывод, к которому пришли; trade-offs, которые были осознаны.
Тело отделяется от subject пустой строкой. Перенос строки — 72 символа.
В теле фиксируются:
Контекст: какой баг, какое требование, какое ограничение среды.
Рассуждение: почему именно это решение, а не другое.
Отвергнутые альтернативы: что было рассмотрено и почему не подошло.
Инварианты: что должно оставаться истинным после этого изменения.
Количественные данные, если применимо: «p99 latency снизилась с 420 мс до 38 мс», «heap allocation сократилась на 40 %».
Пример: плохо — тело пересказывает diff
refactor(invoice): change status field type

Changed status field from String to InvoiceStatus enum.
Updated all usages across InvoiceService, InvoiceRepository,
and InvoiceController.
Пример: хорошо — тело объясняет решение
refactor(invoice): replace raw String status with InvoiceStatus enum

Arbitrary String values for status were accepted silently — a
typo like "piad" was stored without error and caused silent
data corruption downstream in the PDF generator.

Introducing InvoiceStatus enum exhausts all valid states at
compile time. The migration to the existing DB column is safe:
all stored values match enum names (verified via migration
check in V23__validate_invoice_status.sql).

Considered: a separate status validation layer. Rejected because
it moves the invariant away from the domain model — the compiler
then cannot enforce it.

Refs: INV-4401
Практика применения:
Тест на достаточность тела: «если через год разработчик не знает контекста и читает только этот коммит, сможет ли он принять корректное решение о том, нужно ли менять эту логику?» Если нет — тело неполное.
Раздел «Considered / Rejected» важнее остального тела для агента — именно он предотвращает повторное изобретение отвергнутого решения.
Ссылка на тикет идёт в трейлер (см. следующий паттерн), не в свободный текст тела — она должна быть машиночитаемой.
Почему это важно для агента: код отвечает на вопрос «как», коммит с телом — на вопрос «почему». Агент, читающий только код, видит InvoiceStatus enum, но не знает, что String был намеренно заменён после конкретного бага. Без этого знания агент может «упростить» enum обратно до String при следующем рефакторинге — воспроизведя баг INV-4401. Зафиксированные отвергнутые альтернативы закрывают ровно этот класс галлюцинаций.
Git-трейлеры: структурированные метаданные коммита
Анти-паттерн: ссылки на тикеты, авторов ревью, связанные коммиты и задокументированные решения хранятся в свободном тексте тела: «see JIRA PAY-2317», «reviewed by Alice», «fixes the issue». Эти данные не поддаются машинному чтению — агент не может извлечь issue-ID без хрупкого разбора свободного текста.
Реализация:
- Git нативно поддерживает трейлеры — пары
Ключ: значениев конце сообщения, отделённые пустой строкой от тела. По умолчанию разделитель — двоеточие (:); формат хранения в коммите всегда<ключ>: <значение>. Парсинг:git interpret-trailers --parse. Все инструменты (GitHub, GitLab, semantic-release, commitlint) понимают этот формат.
Note |
|
- Стандартный набор трейлеров для Java-проекта с агентной разработкой:
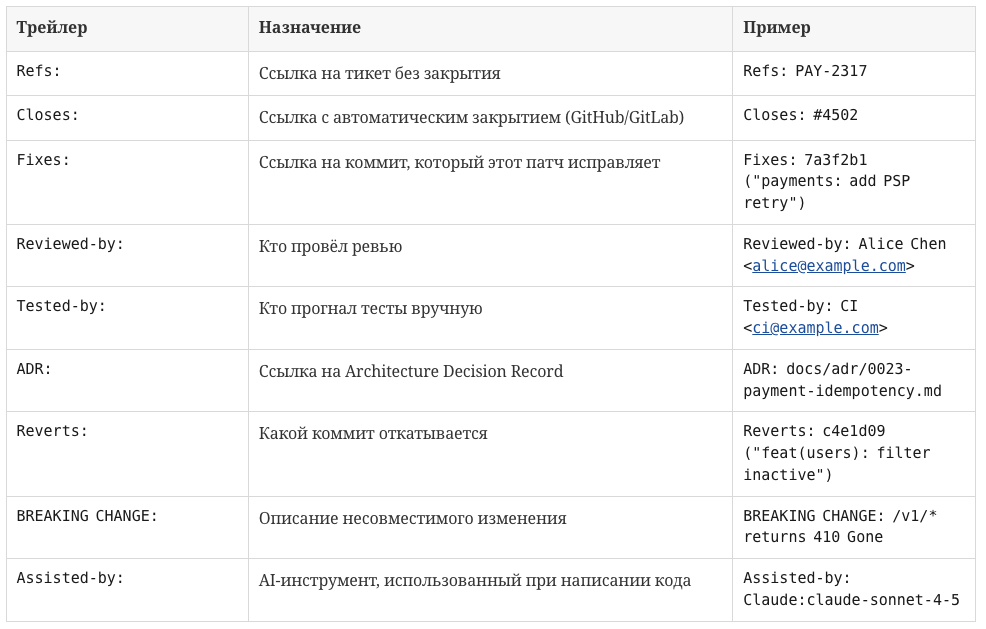
- Трейлеры совместимы со спецификацией Conventional Commits: они образуют корректный «footer» по спецификации и не конфликтуют с semantic-release.
Пример полного коммита с трейлерами
fix(payments): handle 3-D Secure step-up on PSP retry

Stripe occasionally returns `requires_action` on the second charge
attempt even when the first succeeded with SCA. We were treating
this as a failure and scheduling a double-charge.

Now: if the PaymentIntent ID matches an already-captured intent,
we return success immediately without re-charging. Idempotency is
enforced at the domain level, not in the PSP client.

Considered: retry with exponential backoff. Rejected: the issue is
not a transient failure but a PSP state machine quirk — backoff
would triple-charge in the worst case.

Invariant: one PaymentIntent ID maps to exactly one charge.

Refs: PAY-2317
Closes: #4502
Fixes: 7a3f2b1 ("payments: add PSP retry on 5xx")
ADR: docs/adr/0023-payment-idempotency.md
Reviewed-by: Alice Chen <alice@example.com>
Tested-by: CI <ci@example.com>
Парсинг трейлеров скриптом или агентом
# Получить все трейлеры последнего коммита в виде "Ключ: значение"
git log -1 --format=%B | git interpret-trailers --parse
# Co-authored-by: Alice <alice@example.com>
# Fixes: 7a3f2b1
# Refs: PAY-2317
# ADR: docs/adr/0023-payment-idempotency.md

# Найти все коммиты, ссылающиеся на конкретный тикет
git log --all --format='%H %s' | \
  while read hash subject; do
    git log -1 --format=%B $hash | \
      git interpret-trailers --parse | \
      grep -i "^Refs:.*PAY-2317" && echo "\(hash \)subject"
  done
Практика применения:
Тикет не заменяет тело коммита. Правило: коммит самодостаточен — тикет может быть закрыт, мигрирован, утерян. Всё необходимое для понимания изменения должно быть в теле; трейлер — только ссылка.
Closes:для GitHub/GitLab закрывает issue автоматически при merge в default branch.Refs:используется, когда issue остаётся открытым (частичное исправление, связанный контекст).Assisted-by: Claude:claude-sonnet-4-5ставится на коммиты, в написании кода которых участвовал AI-агент. Формат закреплён вDocumentation/process/coding-assistants.rstядра Linux (патч Sasha Levin, отправлен на LKML 23.12.2025, применён Jonathan Corbet в начале апреля 2026). Трейлер рекомендуемый, не обязательный; его цель — audit trail для ревью и security-анализа. Общий формат:Assisted-by: AGENT_NAME:MODEL_VERSION [TOOL1] [TOOL2].
Почему это важно для агента: трейлеры — это структурированные поля в git-логе, эквивалент kv("requestId", …) в runtime-логировании. Агент читает Fixes: 7a3f2b1 и немедленно строит граф «этот коммит исправляет тот» без разбора свободного текста. По ADR: он загружает документ с контекстом архитектурного решения. По Refs: PAY-2317 — подтягивает acceptance criteria из трекера через MCP. Без трейлеров эти связи либо недоступны, либо восстанавливаются приближённо через эвристики.
Стратегия merge: что агент видит в git log main
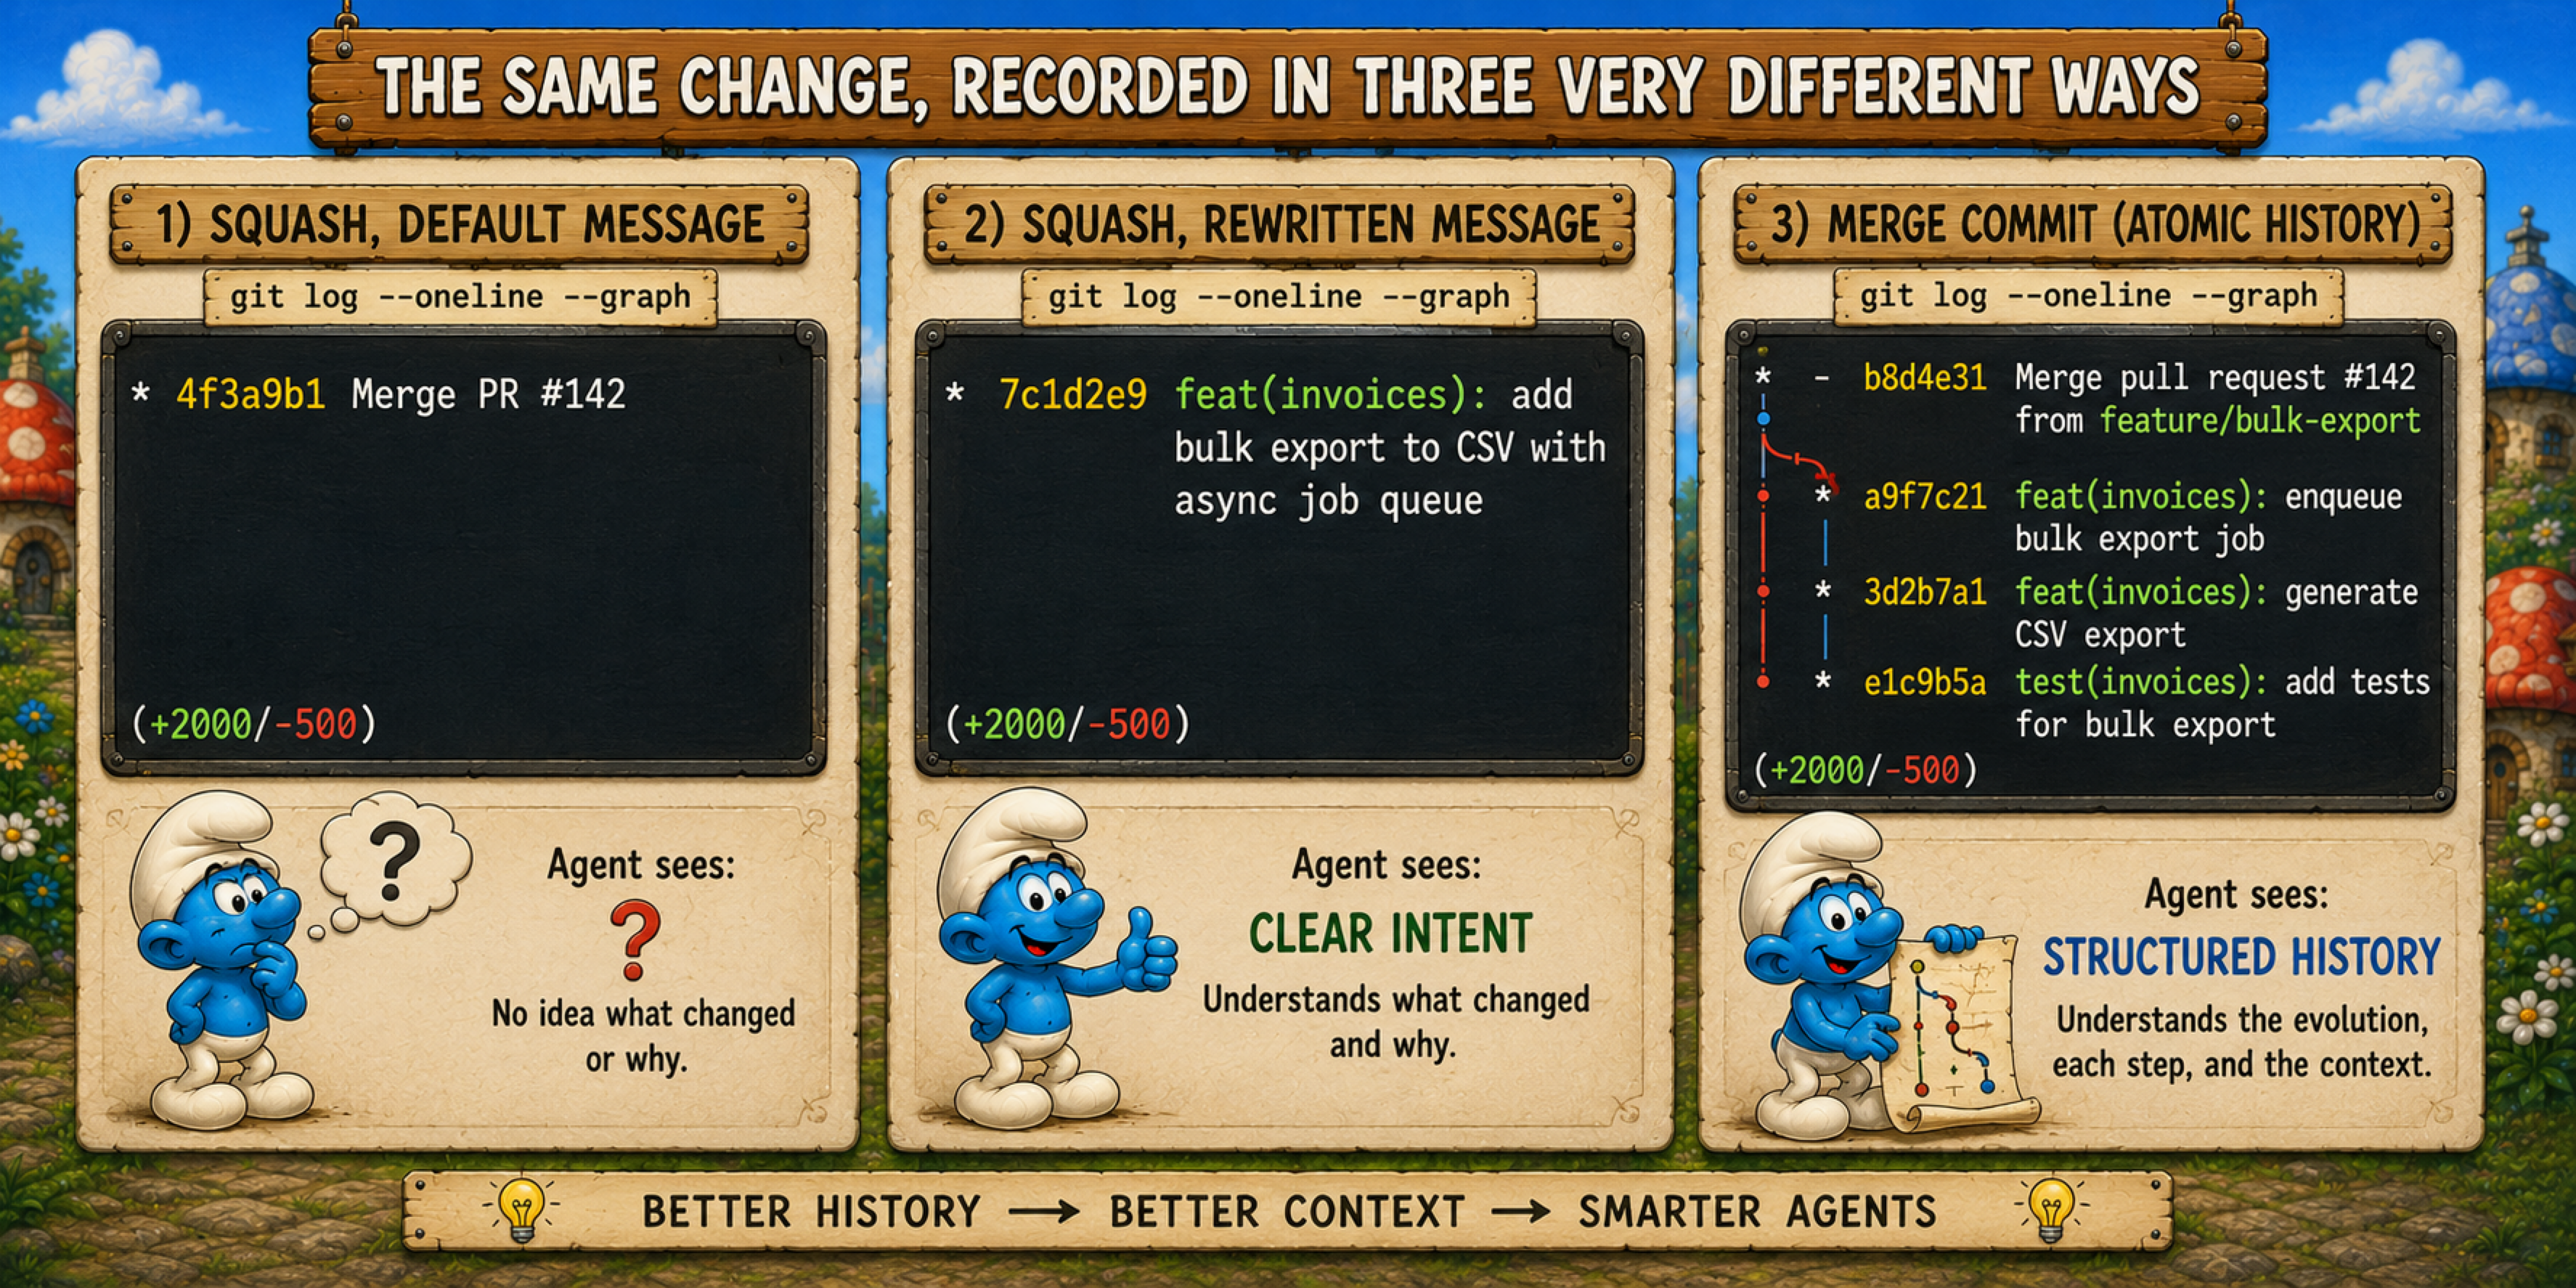
Анти-паттерн: стратегия слияния не определена явно — часть команды делает squash, часть merge commit, часть rebase. Главная ветка содержит смесь: гигантские squash-коммиты (+2000/-500 строк без истории), merge commit’ы с сотнями коммитов «wip», «fix», «fix2», «final», плюс отдельные rebase’d коммиты. git bisect на такой истории теряет смысл.
Реализация:
Стратегия выбирается один раз на репозиторий, фиксируется в CLAUDE.md и настройках GitHub/GitLab. Рекомендуемый вариант для большинства Java-проектов:
Squash and merge для feature-PR с переписанным сообщением в формате Conventional Commits. GitHub позволяет задать шаблон squash-сообщения по умолчанию («PR title + description»). Используется для небольших PR (условно ≤ 200 строк суммарного diff).
Merge commit (
--no-ff) для крупных интеграций (release, hotfix, значимые feature-ветки), где история работы внутри PR сама по себе ценна как документация.Rebase — только для актуализации feature-ветки относительно main перед merge; не для публичных веток.
При squash обязательно переписывается сообщение: не GitHub-дефолт (склейка всех WIP-коммитов), а одно чистое Conventional Commit, описывающее суммарное намерение PR.
Пример: плохо — squash с дефолтным сообщением
# git log --oneline main
a7c3f21 Implement feature (#142)   ← +2000/-500 строк, 23 WIP-коммита
                                     агент читает весь diff без контекста

# squash-сообщение (GitHub default):
# "wip\nwip\nfix\nfix2\naddress review\nfix tests\nfinal\nREALLY FINAL"
Пример: хорошо — squash с переписанным сообщением
# git log --oneline main
a7c3f21 feat(invoices): add bulk export to CSV with async job queue

# squash-сообщение:
# feat(invoices): add bulk export to CSV with async job queue
#
# Invoices > 1000 rows caused timeout on the synchronous export endpoint.
# Large exports are now dispatched to an async job (Spring Batch step)
# and the client polls /exports/{jobId}/status.
#
# Considered: streaming response. Rejected: requires HTTP/2 and causes
# issues with the existing API gateway timeout policy (30 s hard limit).
#
# Refs: INV-5501
# ADR: docs/adr/0031-async-bulk-export.md
Пример: хорошо — merge commit для релизной интеграции
# git log --oneline --graph main
*   d9c4a11 Merge branch 'release/2.4.0' into main
|\
| * c4e1d09 feat(payments): add idempotency key validation
| * b2f7a13 fix(cache): prevent stale state on partial reload
| * 8d3e421 feat(reports): replace N+1 with JOIN in monthly aggregate
|/
* 7a3f2b1 feat(invoices): add bulk export to CSV with async job queue
Практика применения:
Squash-стратегия без переписанного сообщения хуже свободного формата — она уничтожает историю ветки и создаёт один мусорный коммит. Обязательное условие squash: сообщение пишется заново.
git log --oneline main— первый инструмент агента для понимания контекста. Если за последние 20 коммитов 15 выглядят как «Merge PR #NNN» или «fix2» — это сигнал, что история неинформативна.Конфигурация GitHub: Settings → General → «Allow squash merging» с «Default to PR title and description» — включить. «Default message» отключить.
Почему это важно для агента: качество git log main прямо определяет точность ответов агента на вопросы «почему этот код выглядит так» и «когда появилось это поведение». При хорошей стратегии агент выполняет git log --oneline -20 и за секунды получает карту последних изменений с намерениями. При плохой — он читает diff каждого «Merge PR #NNN», пытаясь реконструировать смысл из кода.
Автоматический CHANGELOG и semver-теги
Анти-паттерн: версия проекта поднимается вручную, CHANGELOG.md пишется перед каждым релизом или не ведётся вовсе. Агент не имеет машиночитаемой карты того, какая функциональность появилась в какой версии и какие изменения нарушали обратную совместимость.
Реализация:
Инструмент
semantic-release(Node, запускается в CI) анализирует коммиты с последнего тега, определяет тип релиза по типам коммитов (feat→ minor,fix→ patch,BREAKING CHANGE→ major), генерирует CHANGELOG.md и создаёт git-тег.Для Java-проектов semantic-release вызывается как CI-шаг (GitHub Actions / GitLab CI) — он не зависит от языка проекта, только от формата коммитов.
CHANGELOG.md коммитится в репозиторий вместе с тегом релиза:
Пример: минимальный .releaserc.json для Java-проекта
{
  "branches": ["main"],
  "plugins": [
    "@semantic-release/commit-analyzer",
    "@semantic-release/release-notes-generator",
    ["@semantic-release/changelog", {
      "changelogFile": "CHANGELOG.md"
    }],
    "@semantic-release/github",
    ["@semantic-release/git", {
      "assets": ["CHANGELOG.md"],
      "message": "chore(release): \({nextRelease.version}\n\n\){nextRelease.notes}"
    }]
  ]
}
Пример: фрагмент сгенерированного CHANGELOG.md
## [3.0.0] - 2025-12-01

### ⚠ BREAKING CHANGES
- **api:** remove v1 invoice endpoints — clients must migrate to /v2/*

## [2.4.0] - 2025-11-14

### Features
- **invoices:** add bulk export to CSV with async job queue (INV-5501)
- **payments:** add idempotency key validation on charge endpoint (PAY-2317)

### Bug Fixes
- **cache:** prevent stale invoice state after partial reload (#4502)

## [2.3.1] - 2025-10-30

### Bug Fixes
- **payments:** handle 3-D Secure step-up on PSP retry (PAY-1891)
Пример: конфигурация GitHub Actions для автоматического релиза
# .github/workflows/release.yml
name: Release
on:
  push:
    branches: [main]
jobs:
  release:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0          # нужна полная история для semantic-release
          persist-credentials: false
      - uses: actions/setup-node@v4
        with:
          node-version: 20
      - run: npx semantic-release
        env:
          GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
Практика применения:
fetch-depth: 0в checkout обязателен — semantic-release читает всю историю от последнего тега. Без негоactions/checkoutзабирает только один коммит (глубина 1 по умолчанию), и инструмент не находит базу для сравнения версий.persist-credentials: false— стандартная рекомендация из официального рецепта semantic-release для GitHub Actions.CHANGELOG.md и git-теги — источник истины об эволюции API для агента. Агент отвечает на вопрос «в какой версии появилась функция X» не через поиск по коду, а через
git log v2.3.0..v2.4.0 --onelineили чтение CHANGELOG.md.Стимул дисциплины: плохой коммит (
"fix stuff") не проходит commitlint и не попадает в main; плохое сообщение ("chore: minor things") даёт плохую release-note, видимую всем в GitHub Releases.
Почему это важно для агента: CHANGELOG.md — это индекс эволюции проекта, структурированный по версиям и типам изменений. Агент читает его целиком за одну операцию и получает временну́ю карту: «feature X появилась в 2.4.0, breaking change в 3.0.0, fix для PAY-1891 — в 2.3.1». Без CHANGELOG агент восстанавливает эту карту через многократные запросы к git log, что затратно и ненадёжно.
Assisted-by: — раскрытие AI-участия в истории
Анти-паттерн: код, сгенерированный или существенно отредактированный AI-агентом, коммитится без какого-либо указания на это. Git-история выглядит однородной; при ревью, аудите или разборе инцидента невозможно определить, какие части кода были написаны человеком, а какие — агентом.
Реализация:
- По умолчанию Claude Code добавляет в коммиты:
🤖 Generated with Claude Code
Co-Authored-By: Claude Sonnet 4.6 <noreply@anthropic.com>
Переопределите это поведение:
Co-Authored-By:подразумевает парное авторство и требует парногоSigned-off-by:в проектах с DCO — что семантически некорректно для AI. Настройка управляется через объектattributionв~/.claude/settings.jsonили.claude/settings.local.json; устаревший флагincludeCoAuthoredByболее не поддерживается.Рекомендуемый формат, закреплённый в
Documentation/process/coding-assistants.rstядра Linux (патч Sasha Levin, направлен на LKML 23.12.2025, применён Jonathan Corbet в начале апреля 2026):Assisted-by: Claude:claude-sonnet-4-5Общий формат:
AGENT_NAME:MODEL_VERSION, опционально с перечислением инструментов:Assisted-by: Claude:claude-sonnet-4-5 bash mcp-linear. Трейлер рекомендуемый, не обязательный; политика явно избегает принудительного применения.Signed-off-by:ставит только человек-коммиттер, который берёт на себя ответственность за код. AI-агент не подписывает DCO.Конфигурация переопределяется в CLAUDE.md:
Пример секции в CLAUDE.md
## Git Conventions

### AI Attribution
- NEVER add "Co-Authored-By: Claude" or "Generated with Claude Code" lines.
- Add `Assisted-by: Claude:claude-sonnet-4-5` trailer to every commit
  where Claude wrote or substantially revised the code.
- `Signed-off-by:` is added only by the human committer after review.

### Commit Format
- Conventional Commits 1.0.0: `type(scope): description`
- Subject ≤ 72 chars, imperative mood
- Body: explain *why*, not *how*; include rejected alternatives
- Trailers: Refs:, Closes:, ADR:, Assisted-by:
- Для автоматического добавления трейлера без участия человека:
Пример: git hook prepare-commit-msg
#!/bin/sh
# .git/hooks/prepare-commit-msg
# Добавляет Assisted-by: если переменная CC_ASSISTED установлена агентом

COMMIT_MSG_FILE=$1
COMMIT_SOURCE=$2

if [ "${CC_ASSISTED:-0}" = "1" ]; then
    # Проверяем, нет ли уже трейлера
    if ! grep -q "^Assisted-by:" "$COMMIT_MSG_FILE"; then
        echo "" >> "$COMMIT_MSG_FILE"
        echo "Assisted-by: Claude:${CC_MODEL:-claude-sonnet-4-5}" \
            >> "$COMMIT_MSG_FILE"
    fi
fi
Практика применения:
Трейлер
Assisted-by:— это audit trail, а не стигма. Он позволяет команде и инструментам безопасности быстро идентифицировать коммиты, требующие повышенного внимания при ревью, без ручной аннотации.При разборе инцидента
git log --all --grep="^Assisted-by:" — path/to/fileнемедленно показывает, какие изменения в этом файле были AI-assisted во всех ветках — это значимый контекст для диагностики.Политику раскрытия AI-участия рекомендуется зафиксировать в
CONTRIBUTING.mdнаравне с commit-конвенциями.
Почему это важно для агента: когда агент читает git log с трейлерами Assisted-by:, он получает мета-информацию об источнике кода. Это позволяет ему применять разные стратегии при анализе: код, написанный человеком с телом коммита «Rejected: validation layer — moves invariant away from domain model», заслуживает другого отношения при рефакторинге, чем код, сгенерированный агентом без такого контекста. Трейлер не снижает доверие к коду, но добавляет измерение к истории.
CLAUDE.md: инструкции агенту по работе с историей
Анти-паттерн: агент начинает каждую сессию без контекста — не знает ни формата коммитов проекта, ни структуры веток, ни того, что произошло в репозитории за последние две недели. Первый коммит агента нарушает конвенции; ответы на вопросы «почему здесь такой код» строятся только на анализе текущего состояния файлов.
Реализация:
CLAUDE.mdв корне репозитория содержит обязательную секцию «Git Conventions» и «Context Loading» — инструкции, которые агент выполняет в начале каждой сессии. Для агентов, поддерживающих стандарт AGENTS.md (OpenAI, принят в августе 2025, передан под управление Linux Foundation Agentic AI Foundation в декабре 2025), тот же файл может быть продублирован какAGENTS.mdдля кросс-тулинговой совместимости.Секция «Context Loading» предписывает агенту прочитать историю до начала работы:
Полный шаблон секций в CLAUDE.md
## Git Conventions

### Commit Format
- Conventional Commits 1.0.0: `type(scope): description`
- Types: feat, fix, refactor, test, docs, perf, build, ci, chore, revert
  (revert не тригерит релиз в semantic-release по умолчанию; его задача —
  машиночитаемая разметка отката, а не управление версией)
- Scopes: auth, payments, invoices, cache, reports, api, build, ci
  (defined in .commitlintrc.json)
- Subject ≤ 72 chars, imperative mood ("Add feature", not "Added feature")
- Body (mandatory for feat and fix): explain WHY, not HOW
  - Include: context, reasoning, rejected alternatives, invariants
  - Wrap at 72 chars
- Trailers: Refs: PROJ-NNN, Closes: #NNN, ADR: docs/adr/NNNN-*.md
- AI disclosure: Assisted-by: Claude:claude-sonnet-4-5
- NEVER add: "Co-Authored-By: Claude", "Generated with Claude Code"
- One logical change per commit; each commit must build and pass tests

### Context Loading (run at session start)
1. `git log main..HEAD --oneline --name-status`
   — understand what has changed in this branch vs. main
2. `git log -10 --stat`
   — understand recent project activity and active areas
3. For each file you intend to modify:
   `git log -5 --follow --oneline -- <file>`
   — understand why this file looks the way it does
4. If modifying a method changed in recent history:
   `git log -p -3 -- <file>` and read the commit bodies
   — understand the intent behind recent changes

### Verification Before Commit
- Re-read the full diff: `git diff --staged`
- Ensure one logical change only; if in doubt, split with `git add -p`
- Run lint + tests before committing
- Use `git commit --fixup=<sha>` for review fixes; do not create "fix:" commits
- Секцию «Context Loading» агент выполняет не один раз при создании CLAUDE.md, а каждый раз при начале новой задачи в репозитории. Это его эквивалент MDC-инициализации в runtime-логировании.
Пример: что агент видит после выполнения context loading
$ git log main..HEAD --oneline --name-status
b2f7a13 feat(invoices): add bulk export endpoint (WIP)
M       src/main/java/com/example/invoice/InvoiceController.java
A       src/main/java/com/example/invoice/export/BulkExportJob.java
A       src/test/java/com/example/invoice/export/BulkExportJobTest.java

$ git log -10 --stat
... (10 последних коммитов main с именами файлов и stat)

$ git log -5 --follow --oneline -- src/main/java/com/example/invoice/InvoiceController.java
b2f7a13 feat(invoices): add bulk export endpoint (WIP)
a7c3f21 feat(invoices): add bulk export to CSV with async job queue
c4e1d09 feat(payments): add idempotency key validation on charge endpoint
8d3e421 refactor(invoice): replace raw String status with InvoiceStatus enum
7a3f2b1 fix(invoice): handle null amount in draft state
Из этого вывода агент понимает: контроллер менялся 5 раз, последнее изменение — незафиксированная работа с export. Он читает тело коммита a7c3f21, чтобы понять архитектурное решение по async export, прежде чем вносить изменения в тот же файл.
Практика применения:
CLAUDE.md коммитится в репозиторий и обновляется при изменении конвенций — это живой документ, а не разовая инструкция.
Предписания в CLAUDE.md — advisory; критические правила (формат коммита, запрет
Co-Authored-By: Claude) дублируются как deterministic hooks (commit-msg,prepare-commit-msg), которые не зависят от того, прочитал ли агент инструкцию.Хуки хранятся в
.githooks/(трекается git), а не в.git/hooks/(не трекается). Путь активируется черезgit config core.hooksPath .githooks— эта команда включается вMakefileили скрипт первоначальной настройки репозитория (make setup,bootstrap.sh), чтобы каждый разработчик и каждый CI-runner получали актуальные хуки автоматически при клонировании. Без этого commitlint,prepare-commit-msgи прочие enforcement-механизмы работают только у тех, кто не забыл установить их вручную.
Пример: минимальная настройка .githooks/
# Структура репозитория (трекается git):
# .githooks/
#   commit-msg          ← commitlint
#   prepare-commit-msg  ← Assisted-by: трейлер
#   pre-commit          ← линтер, форматтер

# Makefile (или bootstrap.sh):
setup:
        git config core.hooksPath .githooks
        chmod +x .githooks/*
        npm ci                    # установить commitlint и зависимости

# .githooks/commit-msg
#!/bin/sh
npx --no -- commitlint --edit "$1"
# .gitattributes — пометить хуки как исполняемые при checkout на Unix
.githooks/* text eol=lf
- Simon Willison («Using Git with coding agents», 28.02.2026, https://simonwillison.net/guides/agentic-engineering-patterns/using-git-with-coding-agents/): «Telling the agent to look at recent changes causes it to run
git log, which can instantly load its context with details of what you have been working on recently — both the modified code and the commit messages that describe it».
Почему это важно для агента: CLAUDE.md с секцией «Context Loading» — это инициализация контекста агента перед работой. Без неё агент начинает каждую задачу вслепую: не знает, что уже изменено в ветке, не видит, почему тронутый файл выглядит так, как выглядит, и рискует повторить изменение, которое уже было сделано или отвергнуто. С явными инструкциями агент выполняет контекст-загрузку как часть рабочего процесса — и работает с полной картиной, а не с проекцией текущего состояния файлов.
Заключение
Логирование и git-история — это не инструменты мониторинга и не артефакты процесса разработки. Для агента это единственные каналы, по которым программа сообщает о себе. Всё, что не отражено в логе или в истории коммитов, для агента не существует; всё, что отражено неточно или неполно, становится источником ошибочных выводов. Паттерны этой части построены вокруг одного принципа: наблюдаемость системы должна быть достаточной, чтобы агент мог работать с ней без итеративного добавления инструментов диагностики по ходу работы.
В runtime-логировании это означает, что лог перестаёт быть последовательностью сообщений и становится точной моделью поведения системы. Структурированные записи с идентификаторами сущностей, словарь событий как контракт, переходы состояний с явными полями previousState и newState, сквозной контекст через границы сервисов, полный снимок внешней активности на уровне TRACE — всё это вместе даёт агенту то, чего он лишён по природе: возможность восстановить причинно-следственную цепочку любого наблюдаемого поведения без повторного запуска программы.
В git-истории тот же принцип применяется к эволюции кода. Структурированный формат коммитов, осмысленные имена веток, атомарные изменения, тела коммитов с зафиксированными отвергнутыми альтернативами, машиночитаемые трейлеры — всё это превращает историю из архива в базу знаний о намерениях. Агент, умеющий её читать, не воспроизводит решения, которые уже были отвергнуты, не нарушает инварианты, о которых нигде не написано явно, и не тратит сессию на реконструкцию контекста, который давно зафиксирован в коммитах.
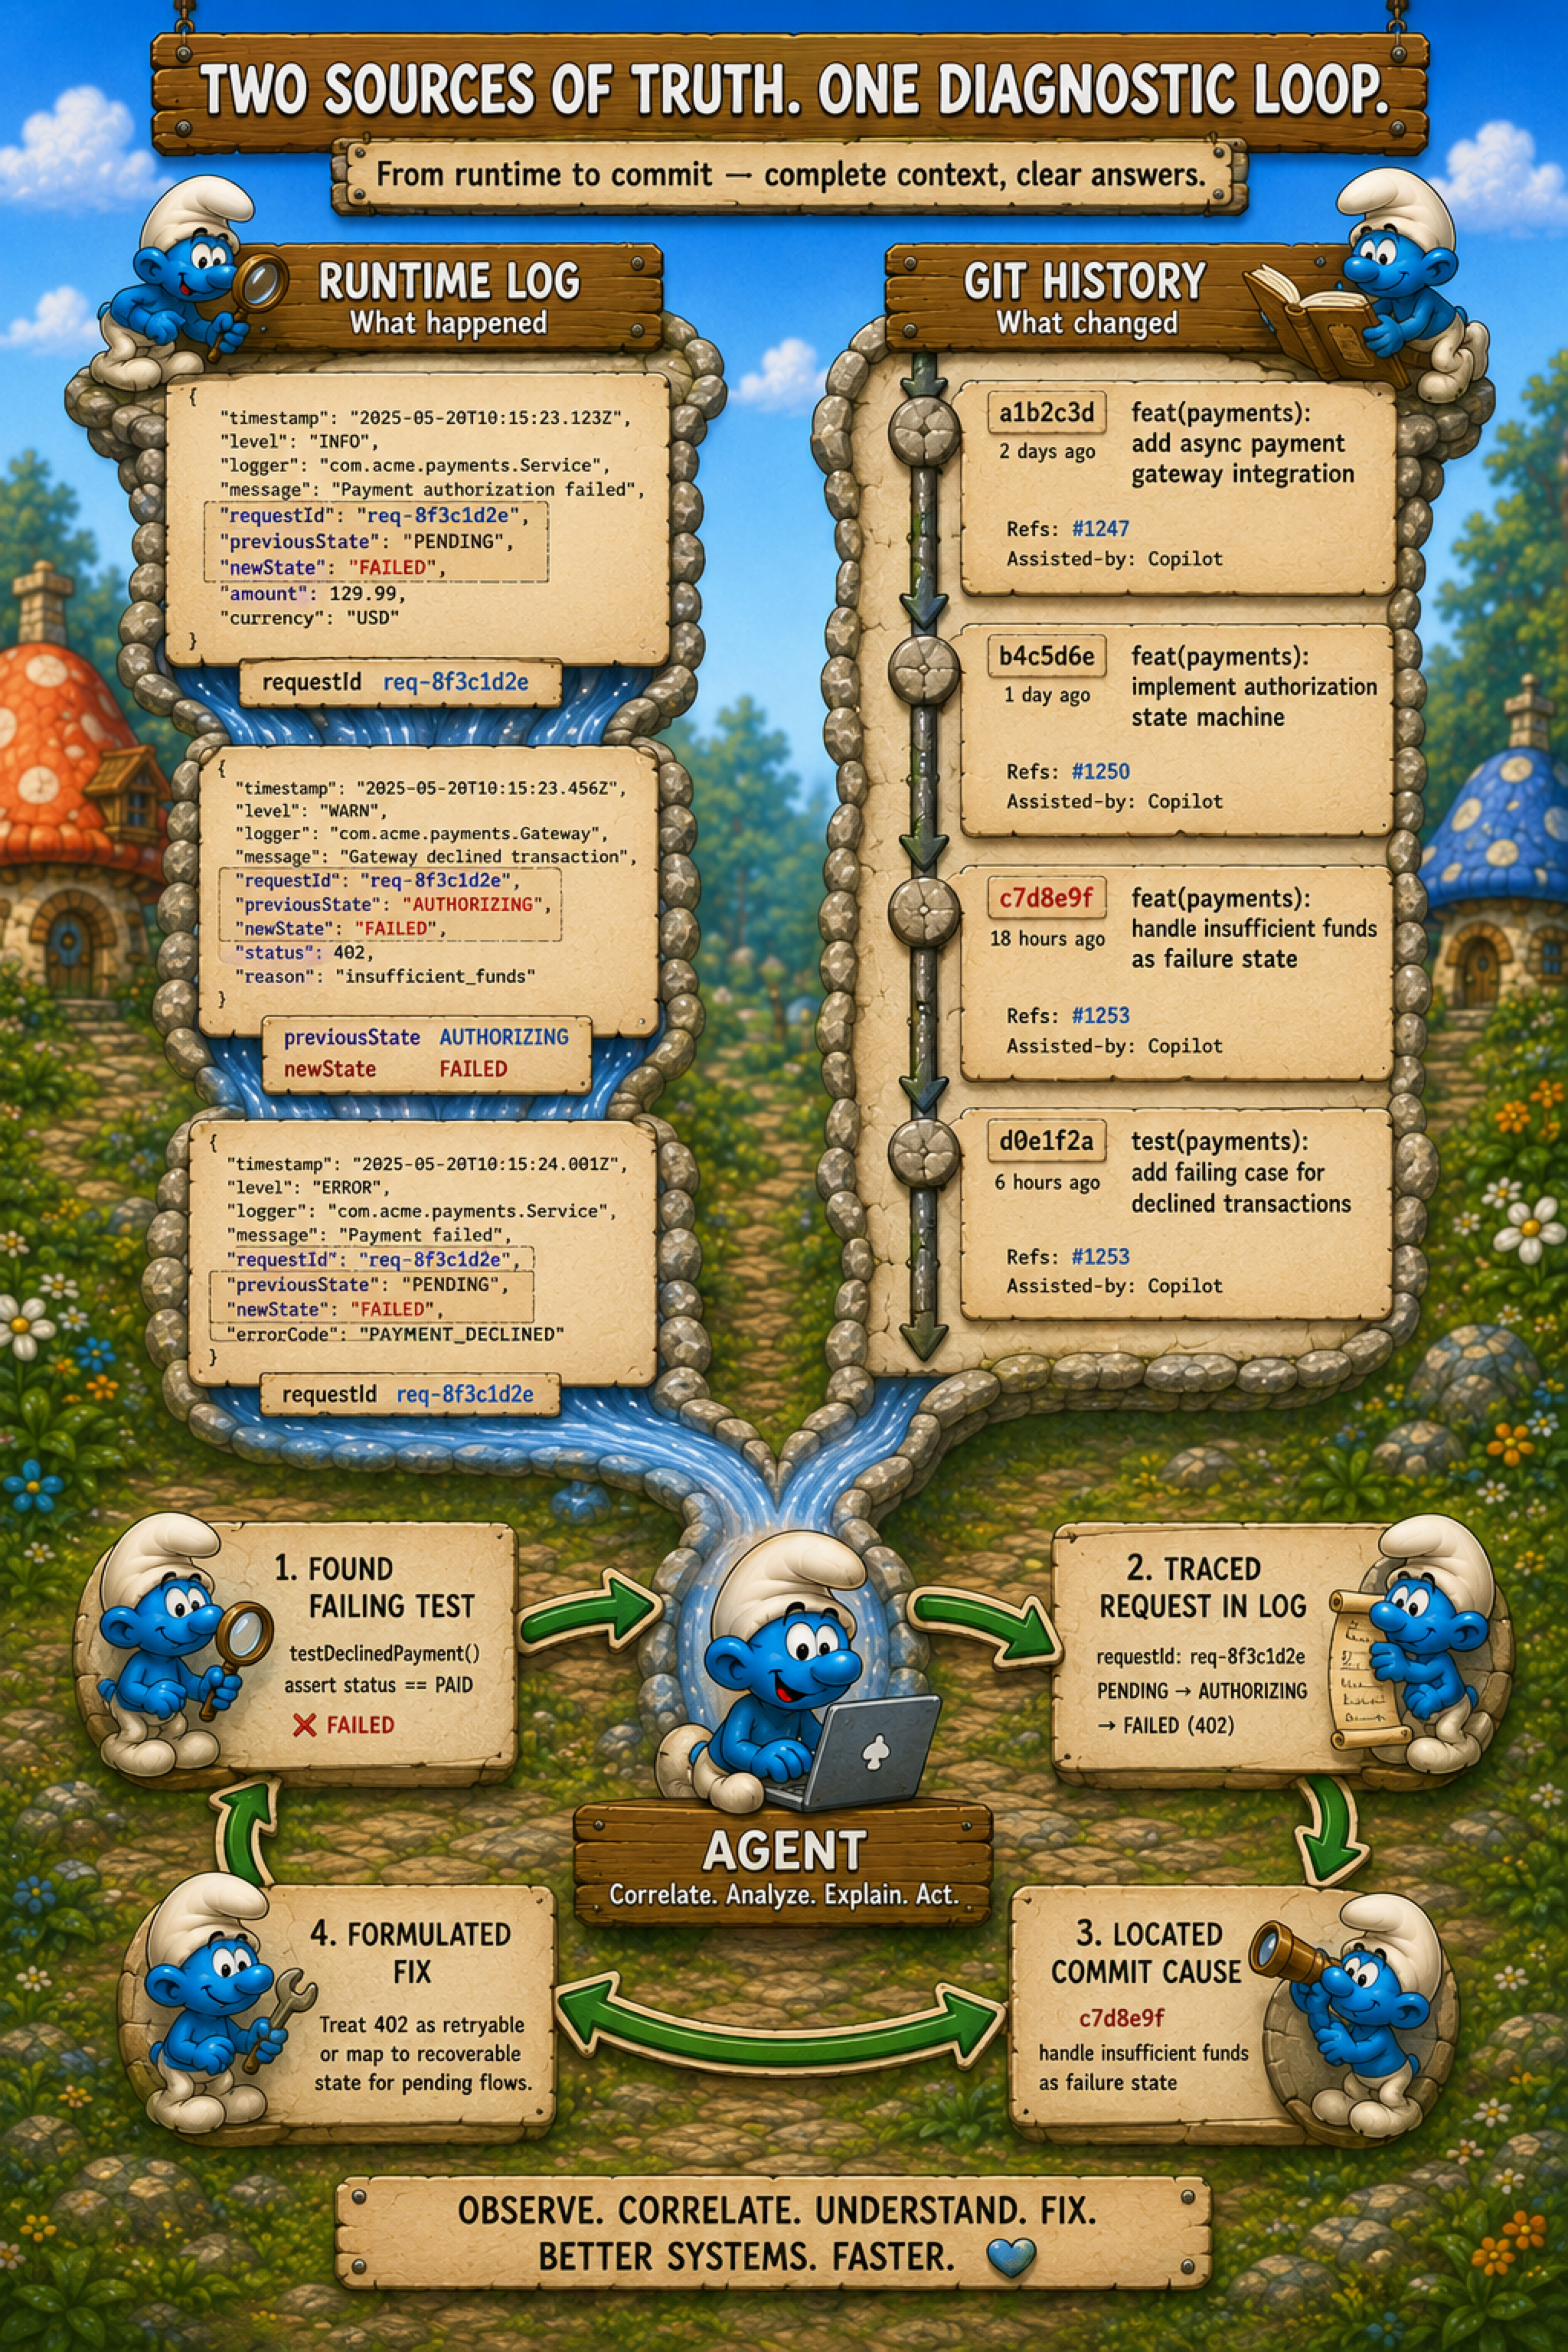
Паттерны обоих блоков усиливают друг друга. Сквозной requestId в runtime-логе и трейлер Refs: в коммите ссылаются на одну и ту же операцию с разных сторон: первый описывает, что произошло во время выполнения, второй — почему код выглядит именно так. Машиночитаемый итог тестового прогона вместе с атомарными коммитами и git bisect run образуют замкнутый цикл диагностики: агент находит упавший тест, по requestId получает полный TRACE-лог, по логу формулирует гипотезу, по git-истории локализует коммит-причину. Ни одно из этих звеньев не работает в полную силу без остальных.
Большинство паттернов решают не только задачу агентной разработки, но и общую задачу сопровождаемости системы. Структурированный лог с propagation-контекстом удобен любому оператору в Kibana. Тело коммита с отвергнутыми альтернативами полезно любому разработчику при ревью. Автоматический CHANGELOG облегчает релизный процесс независимо от того, участвует ли в нём агент. Это не случайное совпадение: хорошо наблюдаемая система и хорошо задокументированная система — одно и то же, просто описанное с разных точек зрения.


